
Engenharia de Software · Arquitetura · Inteligência Artificial
A próxima geração da engenharia de software não acontecerá dentro de um chat
O TESTER precisava reorganizar a suíte. O FIXER estava corrigindo três bugs no mesmo projeto. Eu não queria abrir outra worktree só para contornar a colisão, mas também não queria que os dois inventassem estruturas de teste concorrentes e depois me entregassem um pequeno festival de merge conflicts.
Então defini uma fronteira. O TESTER seria dono do novo layout externo de testes, da configuração, dos cenários de HTTP e SQLite e das regressões do runtime. Outra frente cuidaria do runtime DCMTK no Windows. O FIXER poderia avançar nas correções funcionais, mas deveria esperar o handoff antes de escrever os novos testes. Um agente avisou o outro. O FIXER manteve os testes pendentes, planejou informar quais arquivos havia tocado e só retomaria aquela parte quando a estrutura estivesse pronta.
Esse episódio parece simples porque terminou com uma mensagem. A parte interessante não é a mensagem. É tudo o que precisou existir para ela fazer sentido: responsabilidades diferentes, ownership declarado, uma dependência, um estado de espera, limites de arquivos, uma condição de retomada e uma pessoa decidindo que duplicar trabalho seria pior do que aguardar.
O handoff também não transportou o projeto inteiro. Levou apenas o que o outro responsável precisava para não fazer a coisa errada: “não crie a estrutura ainda”, “estas áreas têm dono”, “estes arquivos já mudaram” e “retome os cenários quando o layout for liberado”. Uma boa coordenação reduz contexto. Ela não replica indiscriminadamente tudo o que cada agente viu.
Isso já não é “conversar com uma IA para gerar código”. É engenharia de software executada por agentes, com coordenação entre trabalhos que podem conflitar.
E essa diferença muda a abstração de que precisamos.
A conversa passa. O que a engenharia precisa lembrar fica nos artefatos.
1. O código ficou abundante. A engenharia, não
Modelos generativos reduziram brutalmente o custo marginal de produzir uma função, um teste, uma migração ou um componente. Em muitos trabalhos, o primeiro diff chega antes de terminarmos de organizar a pergunta. É uma mudança real, útil e difícil de ignorar.
Mas produzir mais código não produz automaticamente um sistema coerente. À medida que a implementação acelera, ficam mais caros os erros que acontecem antes e depois dela: entender o problema errado, aceitar uma premissa fraca, dividir mal o trabalho, testar a interface errada, confundir saída verde com arquitetura correta, perder uma decisão durante a troca de contexto ou promover uma release sem evidência suficiente.
Minha leitura é direta: a IA tornou código abundante; engenharia continuou escassa.
O trabalho escasso agora aparece com mais nitidez. Alguém precisa transformar intenção em um contrato durável. Alguém precisa decidir onde ficam as fronteiras. Alguém precisa comparar o resultado com a especificação, e não apenas com o último prompt. Alguém precisa separar evidência de relato. Alguém precisa dizer “ainda não” quando o pacote existe, mas as plataformas necessárias não foram testadas. E alguém continua responsável quando uma release ruim precisa sair do canal.
Podemos delegar boa parte dessas atividades. Não podemos fingir que elas somem porque o agente escreve rápido.
O chat foi a interface que popularizou essa capacidade. Naturalmente, tentamos esticá-lo até que vire também especificação, backlog, memória, console, revisão, coordenação e sala de controle de release. Funciona por um tempo. Depois começamos a tratar uma sequência de mensagens como se ela fosse o próprio projeto.
Esse é o erro central deste texto: não usar chat, mas promovê-lo a sistema de engenharia.
Quando isso acontece, métricas locais ocupam o lugar de decisões sistêmicas. O agente terminou o turno, então a tarefa parece pronta. O teste passou, então a arquitetura parece correta. O pacote foi gerado, então a release parece publicável. Cada conclusão pula uma fronteira. Engenharia é o trabalho de torná-las visíveis antes que uma sequência rápida de resultados verdes as atravesse por acidente.
2. Chat é ótimo para o trabalho local
Antes de bater no chat, vale reconhecer por que ele venceu. Uma conversa permite explorar uma dúvida sem preparar cerimônia. Posso pedir que um agente leia uma área do repositório, execute testes, compare duas alternativas, corrija um erro e explique o diff. Posso ajustar a direção enquanto aprendo. Para uma tarefa pequena e coesa, essa proximidade entre pergunta, ação e resposta é excelente.
Os coding agents atuais também estão muito além de uma caixa de prompt. Eles leem arquivos, usam terminal e outras ferramentas, atravessam dezenas de turnos e podem criar subagentes. A orientação oficial da Anthropic descreve sessões que carregam conversa, chamadas e resultados de ferramentas e arquivos lidos, além de recomendar uma nova sessão quando começa uma nova tarefa (Anthropic: session management and context). Isso é um ambiente de trabalho, não um autocomplete com balões.
Também não há virtude em fragmentar tudo. Se uma correção tem um único objetivo, uma área de código bem definida e um ciclo curto de validação, mantê-la em uma conversa preserva continuidade e reduz custo de coordenação. Criar cinco papéis, sete documentos e um diagrama de estados para renomear um campo seria uma maneira bastante sofisticada de evitar trabalhar.
O problema começa quando a conversa acumula responsabilidades incompatíveis. A mesma sessão elicita requisito, escolhe arquitetura, implementa, escreve o teste que prova sua própria implementação, revisa o próprio diff e declara a entrega pronta. Cada passo pode parecer razoável isoladamente. O conjunto perde independência.
Uma conversa longa ainda parece uma linha contínua. O trabalho dentro dela já atravessou várias fronteiras. A interface escondeu essa mudança.
Há ainda uma assimetria útil. Continuar no mesmo chat é barato agora e pode cobrar depois, quando alguém precisa reconstruir a decisão. Criar um artefato custa um pouco agora e reduz a reconstrução futura. Não precisamos escolher sempre o segundo. Precisamos reconhecer a dívida que nasce quando escolhemos o primeiro para uma decisão durável.
Portanto, meu argumento não é “abandone o chat”. É mais estreito e mais exigente: use o chat como interface local de trabalho, não como fonte primária de continuidade do projeto.
3. Uma conversa legível não é estado durável
Quando rolamos o histórico e encontramos a mensagem certa, sentimos que o projeto está ali. Não está. Há uma representação parcial do que aconteceu, misturada com tentativas abandonadas, resultados extensos de ferramentas, correções posteriores e decisões que talvez só façam sentido junto de um arquivo que já mudou.
O estado real está distribuído. O código vigente está no repositório. A decisão arquitetural pode estar numa ADR. O contrato aceito pode estar numa spec. A regressão está num teste. O resultado de uma revisão está numa lista de findings. O que pode ser promovido está no manifesto da release. O que foi recusado talvez exista apenas na conversa — e aí já temos um problema.
Uma mensagem diz “vamos usar Git como fonte de verdade”. Um commit implementa metade disso. Uma revisão encontra estado duplicado em outro lugar. Uma correção remove a duplicação. Qual desses itens descreve o sistema? Apenas ler o chat em ordem não responde. É preciso reconciliar intenção, artefato e evidência.
Continuidade de interface também não garante continuidade do executor. O modelo pode mudar. O contexto pode ser compactado. Um subagente pode receber uma seleção diferente de informações. Uma sessão pode reiniciar. O usuário vê a mesma thread; o próximo passo pode estar sendo produzido a partir de outra composição de memória e capacidade.
Por isso gosto de uma regra simples: uma decisão importante não está tomada enquanto só existir no chat.
Ela precisa ganhar uma forma que sobreviva à conversa. Não precisa virar um documento de vinte páginas. Pode ser uma linha numa spec, um teste de contrato, uma ADR curta, um campo de estado, um comentário que explica a restrição, um diff aceito ou uma condição explícita de release. O formato depende da decisão. A exigência é que outro executor consiga encontrá-la, confrontá-la e verificar se continua válida.
Histórico ajuda a entender como chegamos ali. Não deve ser o único lugar que sabe onde chegamos.
Esse princípio muda a forma de encerrar uma sessão. “Resolvido” não significa apenas que o agente apresentou uma resposta. Significa que o estado autoritativo foi atualizado, a evidência relevante tem endereço e qualquer pendência continua visível fora daquela conversa. Se a sessão desaparecer amanhã, o próximo responsável ainda sabe o que vale e o que falta.
Pense numa mudança de autenticação. A conversa pode conter seis alternativas, três snippets e um debate sobre compatibilidade. O estado durável não precisa copiar esse volume. Precisa dizer qual contrato foi escolhido, quais clientes continuam suportados, que ameaça motivou a mudança, quais testes provam o comportamento e que risco segue aberto. O histórico preserva a investigação. Esses poucos artefatos conduzem o próximo trabalho.
Essa redução é diferente de compaction. Ela não tenta adivinhar quais trechos da conversa serão úteis. Um responsável escolhe o que o projeto passa a afirmar e coloca cada afirmação sob uma forma verificável. Se a decisão mudar, o diff mostrará a mudança. Se o teste contradizê-la, teremos um conflito concreto para resolver.
4. Contexto é memória de trabalho
Uma context window reúne o material disponível ao modelo numa execução: instruções, mensagens, chamadas e saídas de ferramentas, arquivos lidos e outros itens que o produto inclui. É muita coisa, mas continua sendo uma seleção finita. Quando algo entra, ocupa espaço. Quando a sessão cresce, o sistema precisa descartar, resumir, substituir ou recuperar conteúdo de alguma maneira.
A analogia que me ajuda é pensar em contexto como RAM, não como base de conhecimento do projeto. Não estou dizendo que os mecanismos sejam iguais. A analogia serve para separar duas funções: memória de trabalho sustenta a tarefa corrente; conhecimento durável precisa continuar endereçável depois que aquela memória muda.
Carregar todo o repositório, todas as decisões, todos os logs e todo o histórico em cada turno não resolveria isso. Mesmo que coubesse, ainda precisaríamos saber qual versão vale, quais decisões foram superadas, quais evidências pertencem a qual claim e quem tem autoridade para mudar o quê. Capacidade não cria semântica.
Também existe um efeito operacional pouco discutido: quanto mais material colocamos na sessão, mais difícil fica perceber qual informação realmente orientou a resposta. Um agente pode ter lido a regra correta e ainda privilegiar um trecho recente. Pode encontrar duas instruções incompatíveis e escolher a errada. Pode interpretar um resultado antigo como atual. A presença da informação é necessária; não é prova de uso correto.
Isso não diminui o valor de contextos grandes. Há tarefas transversais — migrações, auditorias de arquitetura, mudanças de contrato — em que inspecionar áreas distantes do sistema é decisivo. O ponto é que essa inspeção deve produzir ou atualizar artefatos duráveis. Se o entendimento morre junto com a sessão, compramos uma análise cara e não acumulamos conhecimento de engenharia.
O contexto trabalha. O projeto lembra.
Essa separação também evita um uso ruim de instruções gigantes. Quando tentamos carregar todo o manual do projeto em cada prompt, misturamos normas estáveis com fatos temporários da tarefa. As normas deveriam estar em arquivos versionados e carregáveis. O estado temporário deveria estar no workflow. A sessão precisa da fatia relevante dos dois, não de uma autobiografia completa do repositório.
5. Compaction não é um detalhe de interface
Sessões longas precisam atravessar limites. Produtos diferentes fazem isso de formas diferentes, e vale preservar a distinção.
A Anthropic documenta o /compact como substituição do histórico por um resumo lossy. Também explica que saídas antigas de ferramentas podem ser limpas antes da conversa ser resumida; arquivos de instrução do projeto e memória em disco voltam a ser carregados, enquanto uma orientação presente apenas na conversa pode se perder (Claude Code glossary). “Lossy” aqui não é uma acusação minha. É a descrição do próprio mecanismo.
A OpenAI descreve outra forma. Na Responses API, a janela seguinte pode receber um item de compaction criptografado e eficiente em tokens, junto de conteúdo anterior selecionado, com o objetivo de manter uma continuação coerente (OpenAI: compaction no ambiente de agentes). Ao explicar o loop do Codex, a empresa diz que a entrada é substituída por uma lista representativa menor e que a compaction pode aparecer como um item opaco do tipo compaction (OpenAI: unrolling the Codex agent loop).
Não temos base para dizer que os dois mecanismos perdem as mesmas coisas ou se comportam de forma equivalente. Temos base para uma conclusão mais modesta: compaction é uma transição de estado. Depois dela, a conversa visível pode continuar, mas a representação efetivamente entregue ao próximo executor mudou.
Esse detalhe importa quando a sessão contém uma decisão que ainda não foi materializada. Se uma restrição existe apenas numa troca de mensagens antiga, passamos a depender da política de preservação de um mecanismo criado para reduzir tokens. Talvez ele preserve. Talvez não. Engenharia não deveria repousar no “talvez” quando custa pouco gravar a decisão no artefato correto.
Compaction é útil. Tratar compaction como persistência é que não é.
Na prática, isso pede um registro antes da transição. Não um resumo automático mais bonito, mas uma atualização dos artefatos que têm autoridade: critérios aceitos na spec, finding ainda aberto, teste que continua falhando, arquivo sob ownership de outra frente, decisão de release pendente. O chat pode produzir esse registro. O que não pode é continuar sendo seu único recipiente.
6. A advertência que o resumo deixou para trás
A própria documentação da Anthropic traz um exemplo revelador. Numa sequência de trabalho, o agente havia encontrado um warning. A tarefa seguinte mudou de direção. Como o resumo não conseguia prever que aquela advertência seria relevante depois, ela foi omitida na compaction. A recomendação prática é preservar explicitamente o estado relevante e considerar uma nova sessão para uma nova tarefa (Anthropic: session management and context).
Esse caso não aconteceu no meu projeto, e não vou fingir que aconteceu para deixar a história mais dramática. Ele é útil justamente porque expõe o mecanismo sem folclore: um resumo otimiza para continuidade provável. Engenharia precisa preservar também o que pode voltar a importar de maneira improvável.
Warnings, hipóteses rejeitadas e limitações conhecidas têm esse comportamento. Enquanto estamos corrigindo um endpoint, uma limitação do empacotamento parece lateral. Duas horas depois, na release, ela vira o assunto principal. Uma conversa organizada pelo fluxo temporal tende a empurrar esses elementos para trás. Um registro de risco os organiza pela obrigação que ainda não foi satisfeita.
É a diferença entre “o agente mencionou isso” e “o projeto sabe disso”.
Quando uma descoberta muda um próximo gate, ela deve sair da narrativa e entrar no estado de engenharia. Um warning relevante pode virar teste. Uma hipótese operacional pode virar item pendente. Uma incompatibilidade pode bloquear a promoção. Uma decisão provisória pode ganhar prazo e responsável. Nada disso exige uma plataforma gigantesca; exige disciplina para não confundir lembrança conversacional com obrigação persistente.
Quanto mais autônoma parecer a execução, mais importante fica essa disciplina. A continuidade suave é confortável. Também pode esconder que uma informação caiu fora do conjunto de trabalho.
“Preservar tudo” também não é a resposta. Um log infinito torna a recuperação cara e mantém contradições antigas ao lado das decisões vigentes. Conhecimento durável exige curadoria: registrar a conclusão no lugar certo, ligar a evidência, marcar o que foi superado e manter histórico pelo mecanismo de versão. Acumular mensagens é armazenamento; não necessariamente memória útil.
7. Trocar o modelo troca o executor
Uma thread pode permanecer visualmente idêntica enquanto o modelo muda. Para o usuário, a conversa continua. Computacionalmente, outro executor lê o material disponível, com outra configuração e outro cache.
A documentação do Claude Code afirma que cada modelo mantém seu próprio prompt cache e que /model faz a requisição seguinte ler a mesma conversa sem cache hits. Também descreve modos que usam modelos diferentes para planejamento e execução, além de fallback automático (Anthropic: prompt caching). A mudança não apaga o transcript. Ela muda quem o interpreta e sob quais trade-offs.
Vi essa especialização num fluxo real. Uma sessão Claude configurada com esforço xhigh recebeu de um agente Codex dedicado à especificação um pedido de segunda revisão independente. O fato importante não é o nome do provider, muito menos uma suposta tabela universal de vencedores. Foi a alocação deliberada: revisão de especificação, contexto fresco, provider escolhido e esforço alto para aquele trabalho.
Isso é bem diferente de trocar de modelo no meio da conversa porque o menu estava à mão. Se o trabalho tem uma responsabilidade clara, consigo avaliar a escolha: qual contexto ele recebe, qual saída deve produzir, quanto custa, quanto demora e que evidência permitirá aceitar o resultado. Sem essa moldura, “usar o modelo mais forte” é só terceirizar a arquitetura para um seletor.
Os níveis de esforço também não são selos de qualidade. A documentação oficial de OpenAI recomenda avaliar modelos e configurações em workloads representativos, em vez de presumir que o esforço máximo sempre é a melhor opção (OpenAI: model selection). Mais raciocínio pode ajudar numa revisão difícil e desperdiçar tempo numa alteração mecânica. Um modelo barato pode ser ótimo para uma inspeção limitada e péssimo para arbitrar uma mudança arquitetural.
Especialização não é culto ao modelo. É alocação de trabalho com critérios observáveis.
Também evita uma dependência invisível do executor. Se uma responsabilidade tem contrato de entrada e saída, consigo trocar o modelo e comparar resultados sem redefinir o workflow inteiro. Se “o agente” é uma personalidade onisciente que sabe tudo porque esteve na conversa desde o início, qualquer troca se torna traumática. A modularidade vale para modelos pelo mesmo motivo que vale para código: mudanças ficam menos espalhadas quando as dependências são explícitas.
8. O melhor argumento a favor de contextos maiores
Há uma resposta forte à minha tese: se o problema é informação perdida entre conversas, aumente o contexto. Um agente que lê mais código e preserva mais histórico precisa de menos handoffs. Reduzimos a fragmentação, mantemos a linha de raciocínio e evitamos uma camada de coordenação que também pode falhar.
Concordo com boa parte disso.
Contexto maior reduz fronteiras artificiais. Uma análise arquitetural pode exigir contratos, implementações, testes e histórico de várias áreas. Quebrá-la cedo demais força cada agente a trabalhar com uma fatia que talvez esconda o problema real. Há pesquisa ativa tentando tornar atenção longa e retrieval mais eficientes; a SubQ, por exemplo, publica alegações próprias sobre atenção esparsa e treinamento em comprimentos extensos. Essas alegações não têm reprodução independente estabelecida no material que consultei, mas bastam para lembrar que a evolução não parou (SubQ technical report).
Também não devemos transformar um paper antigo em lei da natureza. O estudo Lost in the Middle, publicado em 2024, encontrou efeitos de posição em tarefas de pergunta e resposta sobre múltiplos documentos e recuperação key-value: os modelos avaliados frequentemente iam melhor quando a informação relevante estava no começo ou no fim e pior quando estava no meio (TACL: Lost in the Middle). Isso mostra que tamanho nominal não garantia uso uniforme naquele conjunto de modelos e tarefas. Não mede os modelos de 2026 nem os meus repositórios.
Ainda assim, contextos maiores não resolvem o problema de autoridade. Eles não dizem qual decisão foi aprovada. Não tornam uma revisão independente. Não impedem duas frentes de editar o mesmo arquivo. Não preservam por si mesmas um gate de release. E não convertem uma hipótese em teste.
Use contexto grande quando a visão transversal for load-bearing. Só não peça a ele que faça também o trabalho de Git, especificação, ownership, revisão e estado operacional. É muita responsabilidade para uma janela, por maior que ela fique.
Há um teste simples para separar necessidade de contexto de necessidade de coordenação. Se o problema é que uma decisão depende de informações espalhadas, amplie a inspeção. Se o problema é que dois trabalhos podem conflitar, que uma aprovação deve ser independente ou que uma ação precisa esperar outra, modele a relação. Mais leitura resolve desconhecimento. Não resolve ownership.
9. Conhecimento é o que pode ser reencontrado e confrontado
Chamo de conhecimento de engenharia aquilo que um executor posterior consegue localizar, interpretar e verificar sem depender da memória privada de uma sessão.
Uma especificação registra o comportamento desejado e as decisões ainda abertas. Uma ADR explica por que uma escolha estrutural foi feita e o que ela exclui. O Git mostra a evolução concreta e permite diff e blame. Testes codificam exemplos e invariantes executáveis. Findings de review ligam uma preocupação a trechos do sistema. Evidências de release registram o que foi validado, em quais plataformas e com quais limitações.
Nenhum desses artefatos é perfeito. Uma spec pode estar desatualizada. Um teste pode provar a coisa errada. Um commit pode misturar mudanças. Uma ADR pode racionalizar uma decisão depois do fato. Durabilidade não garante verdade.
Ela permite contestação.
Esse é o salto. No chat, uma decisão pode se dissolver na sequência. Num artefato versionado, outra pessoa ou outro agente consegue dizer: “o código não cumpre este critério”, “este teste cobre só macOS”, “esta ADR pressupõe uma fonte de verdade que o runtime duplicou”, “este pacote ainda não pode ser promovido”. O conhecimento fica sujeito a revisão porque tem endereço e forma.
No meu projeto, uma ADR define especificações como arquivos versionados e separa esse contrato do status e das saídas de runtime. Outra decisão registra mensagens duráveis, estados explícitos de entrega, comportamento após reinício e submissões ambíguas, sem tratar scraping de terminal como fonte de verdade. Essas escolhas não tornam o sistema infalível. Tornam suas promessas discutíveis e testáveis.
O objetivo não é documentar tudo. É persistir o que alguém precisará recuperar para tomar a próxima decisão corretamente.
Um artefato durável precisa de quatro propriedades práticas. Deve ter uma autoridade conhecida: sabemos se ele manda ou apenas informa. Deve ser versionado, para distinguir a decisão atual das anteriores. Deve ligar intenção a evidência, quando a conclusão depende de prova. E deve ter um ciclo de vida: uma spec concluída, um finding resolvido e uma release retirada não podem permanecer eternamente com o mesmo significado.
Sem essas propriedades, apenas mudamos o problema de lugar. Um wiki sem dono pode ser tão enganoso quanto uma conversa antiga. Um dashboard que replica estado com atraso adiciona uma segunda versão da realidade. Persistência vale quando reduz ambiguidade, não quando cria mais uma tela para consultar.
10. Decompor por responsabilidade não nasceu com agentes
Muito antes de LLMs, David Parnas argumentou que a forma de decompor um sistema afeta sua flexibilidade e compreensão. Sua alternativa organizava módulos em torno de decisões de design que poderiam mudar, escondidas atrás de interfaces, e não apenas em torno das etapas de processamento (Parnas: On the Criteria To Be Used in Decomposing Systems into Modules).
Eric Evans, em DDD, descreve bounded contexts como limites dentro dos quais um modelo específico se aplica e context maps como uma forma de explicitar as relações entre esses contextos (DDD Reference). Nenhum dos dois estava prescrevendo um agente por módulo, um agente por contexto ou uma startup de orquestração. A analogia útil é outra: fronteiras existem para controlar significado, mudança e dependência.
Quando separo SPEC, CODER, TESTER, REVIEWER e RELEASE, não estou afirmando que precisamos de cinco processos para toda tarefa. Estou tornando explícitas cinco responsabilidades que pedem entradas, critérios e graus de independência diferentes.
O agente de especificação trabalha com intenção, contradições, acceptance criteria e decisões abertas. O agente de implementação trabalha com spec e estado do repositório. O de testes precisa do contrato, dos riscos e das fronteiras de cobertura. O reviewer precisa de diff, objetivo e distância suficiente para não apenas defender a solução criada. O responsável por release precisa de artefatos, gates, compatibilidade e plano de rollback.
Uma única sessão pode executar várias dessas responsabilidades quando o risco é pequeno. O problema é deixá-las implícitas. Se ninguém sabe quando a implementação terminou e a revisão começou, também não sabe qual evidência deveria mudar, qual contexto deveria ser renovado e quem pode rejeitar o resultado.
Uma matriz simples ajuda a manter a distinção sem transformar o fluxo numa religião:
| Responsabilidade | Entrada durável | Evidência de saída | Autoridade humana |
|---|---|---|---|
| Especificação | intenção, restrições e decisões anteriores | critérios, contradições e questões abertas | fecha escopo e trade-offs |
| Implementação | spec e estado do repositório | diff, build, tipos e testes pertinentes | aceita direção e mudanças estruturais |
| Testes | contrato e cenários de risco | resultados e limites de cobertura | decide mudanças de API por testabilidade |
| Review | spec, diff e checks | findings ligados ao código ou contrato | aceita, rejeita ou prioriza findings |
| Release | candidato, gates e plano de rollback | checks de plataforma e estado dos canais | promove, aborta ou reverte |
Essa tabela não determina quantidade de agentes. Uma pessoa ou sessão pode ocupar mais de uma linha. Ela mostra onde muda a pergunta e onde um resultado local deixa de ser suficiente.
Bilhões de parâmetros não aboliram decomposição. Só tornaram mais fácil ignorá-la por alguns commits.
11. Especificação: intenção precisa virar contrato
Em uma das sessões, comecei revisando uma spec de refactoring que substituiria o conceito de task por Specification. As primeiras respostas não foram “implemente”. Foram decisões.
Aceitei mudar contrato. Delimitei que não haveria migração porque o cenário era de banco novo. Pedi que a allowlist do MCP acompanhasse a troca de nome. Depois ampliei conscientemente o escopo: acceptanceCriteria[] no lugar de definitionOfDone, estados como draft, ready, in_progress, verifying, done e blocked, além de evidence, outputs, traceability, comportamento no backlog, materialização no canvas e uma relação mais forte com coding agents. Também determinei code reviews por etapas.
O valor da sessão não está na quantidade de campos. Está em transformar respostas provisórias em um arquivo que a implementação e a revisão poderiam usar. A spec passou a registrar o que seria removido, que compatibilidade não era necessária, quais estados existiriam, quais evidências deveriam aparecer e onde haveria gates.
Sem esse artefato, o implementador receberia a lembrança condensada de uma discussão. Poderia acertar o nome e perder a semântica. Poderia preservar uma compatibilidade que eu havia descartado ou, pior, descartar uma que ninguém discutiu. O reviewer teria de inferir a intenção olhando o diff — arqueologia quase em tempo real.
Especificar não significa congelar. Eu mudei o próprio requisito durante a conversa. A função da spec é registrar a melhor decisão atual e tornar sua mudança explícita. Uma especificação versionada admite revisão, diff e substituição. Um prompt antigo apenas continua existindo, cercado por mensagens que talvez o tenham superado.
O contrato durável não serve para controlar o agente palavra por palavra. Serve para impedir que a direção do trabalho dependa da recordação mais conveniente do último turno.
Há uma diferença importante entre spec e plano. O plano organiza como executar; a spec registra o comportamento e as decisões que a execução precisa respeitar. Um plano pode mudar porque um arquivo está em conflito ou uma ferramenta falhou. A aceitação do produto não deveria mudar silenciosamente junto. Misturar os dois faz uma limitação operacional reescrever o requisito sem ninguém decidir.
Foi por isso que os code reviews por etapas entraram na própria especificação. Não eram lembretes simpáticos para “dar uma olhada depois”. Eram gates ligados à mudança. O fluxo poderia adaptar a ordem das tarefas, mas não declarar a transformação completa sem atravessar as revisões combinadas.
12. Implementação: velocidade precisa de uma fonte de verdade
Outra frente implementou um ciclo Git para coding agents em worktrees. Entraram metadados de branch e base, comandos para rebase e finalização, validação de worktree e workspace limpos, merge de volta à branch de origem, remoção da worktree e tratamento de conflito com abort e erro explícito. O estado visual também passou a mostrar informações Git e ações correspondentes.
O relatório de validação era convincente: build, type check, lint e 94 testes passaram. Havia cobertura de criação com metadata, rebase, finalização com cleanup, rejeição de workspace sujo e conflito abortado. Tudo verde.
Então pedi code review.
A revisão encontrou dois problemas médios e dois baixos. O ponto arquitetural mais importante era estado duplicado. Em vez de manter uma representação paralela sujeita a drift, escolhi Git como fonte de verdade e autorizei uma simplificação seguida de nova revisão. A trilha de implementação ficou corroborada no histórico do repositório pelo commit do trabalho de worktrees.
Isso não prova que toda suíte verde esconde quatro problemas. Não mede taxa de defeitos. Prova algo bem mais localizado e suficiente: naquela implementação, automação verde não tornou a revisão redundante. Os checks disseram que propriedades codificadas continuavam válidas. O reviewer questionou uma decisão que os testes não haviam sido escritos para rejeitar.
A distinção importa. Build verifica se o projeto compila. Tipos verificam relações expressas no sistema de tipos. Lint aplica regras configuradas. Testes exercitam cenários escolhidos. Nenhum deles decide sozinho se duas fontes de estado deveriam existir.
Quando código chega barato, revisar a direção fica mais importante, não menos. Um diff grande pode estar impecavelmente implementado na direção errada.
O histórico Git teve outra função aqui: separar relato de artefato. A sessão dizia quais checks haviam passado e narrava a decisão. O commit confirmava que o episódio de worktrees deixou uma mudança durável no repositório. Nenhum dos dois, sozinho, prova toda a correção. Juntos, permitem afirmar a sequência sem promover o relatório do agente a verdade universal.
13. Testes: independência sem deformar o produto
No episódio do TESTER e do FIXER, o agente de testes não recebeu a missão vaga de “aumentar cobertura”. Ele ganhou ownership do layout externo, dos cenários de regressão e de áreas delimitadas: configuração, HTTP, SQLite e testes de integração. A hot pipeline não poderia mudar de comportamento. Outra frente cuidaria de DCMTK e CI.
Essa divisão evitou duas tentações comuns. A primeira seria o FIXER criar testes no layout antigo para encerrar seu trabalho rapidamente, obrigando o TESTER a movê-los ou duplicá-los. A segunda seria o TESTER invadir a área funcional de outro agente para tornar sua própria tarefa mais simples.
Houve ainda uma decisão local de testabilidade. O agente recusou ampliar uma API de produção, expondo Deserialize, apenas para facilitar um teste. Preferiu um caminho de integração real. Não extraio daí a regra “nunca mude uma API para testar”. Testabilidade pode revelar um design fechado demais. Aqui, porém, abrir o contrato público não era necessário para observar o comportamento desejado. A conveniência do teste não justificava aumentar a superfície do produto.
Esse é um exemplo de como responsabilidade especializada melhora a pergunta. Um agente genérico pode pensar “como faço este teste passar?”. Um TESTER com limites claros precisa perguntar “qual comportamento devo provar, por qual interface legítima e sem alterar a hot pipeline?”.
Independência não significa isolamento. Ele precisou coordenar com o FIXER, informar o momento do handoff e respeitar a área do runtime Windows. A qualidade apareceu na fronteira, não na solidão.
O resultado final end-to-end dessa sequência não está provado pelo recorte de evidência que tenho. Não vou transformá-la numa história de sucesso total. O que está documentado é o mecanismo: ownership, espera deliberada, escopo estreito e escolha explícita de não deformar a API por conveniência.
Para esse mecanismo funcionar, o handoff precisa ser pequeno e verificável. Quem entrega informa o que mudou, o que não mudou, quais arquivos estão sob risco de colisão, que validações já rodaram e qual condição libera a próxima etapa. Quem recebe confirma a fronteira e mantém pendências explícitas. “Pode continuar” sem estado associado só desloca a ambiguidade para outra conversa.
Há uma consequência contraintuitiva: esperar pode ser progresso. O FIXER avançou no que era independente e deixou testes pendentes até receber a estrutura correta. Forçar paralelismo total teria produzido mais atividade e menos coordenação. Em sistemas com agentes, utilização máxima não é uma boa proxy para throughput do trabalho aceito.
14. Review: um novo papel, não um novo prompt
Pedir “revise seu trabalho” no fim da mesma sessão é melhor do que não revisar. Ainda carrega o mesmo enquadramento, as mesmas premissas e a tendência natural de explicar por que a solução existente faz sentido.
Uma revisão independente muda três coisas. Primeiro, recebe como objeto o diff e o contrato, não a memória de ter criado ambos. Segundo, pode usar contexto fresco, sem a longa sequência de pequenas justificativas que normalizou a solução. Terceiro, produz findings que alguém pode aceitar, rejeitar ou priorizar separadamente da implementação.
Foi assim que checks verdes e uma revisão coexistiram no caso das worktrees. A implementação provou vários cenários. A revisão expôs questões de desenho, incluindo a duplicação de estado. A decisão humana não foi “o reviewer sempre tem razão”. Foi examinar o finding e escolher Git como autoridade.
O mesmo raciocínio vale para uma segunda revisão de especificação. Na sessão cross-provider, o agente revisor recebeu uma responsabilidade nomeada e um pedido vindo do agente de spec. Configurar esforço xhigh não garantiu qualidade; tornou explícita uma aposta de custo e profundidade para aquele trabalho. O resultado ainda precisava ser julgado.
Review não é um ritual para fabricar quatro findings e justificar a existência do reviewer. Um bom review pode retornar zero. Também pode contestar o requisito, o teste ou a fronteira de ownership, não apenas uma linha de código. Sua independência é útil quando o custo de um enquadramento compartilhado supera o custo de mais contexto e latência.
Se toda revisão sempre concorda com a implementação, talvez o código seja extraordinário. Talvez os dois agentes estejam apenas compartilhando o mesmo ponto cego. Vale descobrir qual das opções é menos confortável.
Independência, contudo, não exige ignorância artificial. Um reviewer precisa da spec, do diff e dos checks. O que ele não precisa é de toda a narrativa persuasiva do implementador. Findings devem citar o mecanismo e a consequência: qual estado pode divergir, qual contrato foi violado, qual falha não está coberta. “Não gostei” é opinião; “estas duas fontes podem divergir após esta transição” é uma hipótese verificável.
15. Especialização é uma decisão econômica
Depois que responsabilidades ficam explícitas, provider, modelo, reasoning effort, ferramentas e contexto deixam de ser preferências globais. Viram recursos alocados a um trabalho.
Uma inspeção mecânica pode pedir um modelo rápido, pouco contexto e ferramentas de busca. Uma mudança de arquitetura pode justificar contexto transversal e esforço maior. Um teste de integração precisa do ambiente e dos serviços corretos, não necessariamente do modelo mais caro. Uma revisão independente talvez se beneficie mais de contexto fresco do que de mais tokens na mesma sessão.
As recomendações de vendors ajudam, mas não são benchmarks neutros. A Anthropic sugere famílias diferentes para coding geral, raciocínio complexo e subagentes simples em sua orientação de custos (Anthropic: manage costs). A OpenAI oferece famílias com posições distintas de capacidade e custo e orienta testar configurações no workload real (OpenAI models). Ambas as fontes podem mudar. Nenhuma autoriza declarar um campeão universal.
O exemplo Claude/Codex com xhigh mostra uma configuração real, não uma comparação controlada. Não sabemos como outro modelo se sairia na mesma spec, com o mesmo prompt, contexto e critério. Dizer mais seria marketing fantasiado de engenharia.
O critério que me interessa é verificável: o trabalho tem objetivo e fronteira? A entrada necessária está disponível? A saída pode ser confrontada com evidência? O custo e a latência fazem sentido para o risco? Existe fallback quando o provider falha ou pede uma permissão que o sistema não consegue interpretar?
Model routing sem responsabilidade definida otimiza uma coisa nebulosa. Com responsabilidade definida, podemos medir por tarefa, corrigir a alocação e até descobrir que uma única sessão era suficiente.
Isso também contém custos. Um agente de revisão com contexto fresco consome tokens e tempo; um provider adicional amplia superfície operacional; esforço alto aumenta latência. O benefício precisa aparecer em decisões melhores, riscos encontrados ou independência necessária. Contar agentes e chamadas como sinal de sofisticação é tão útil quanto contar classes para medir arquitetura.
16. Quando a orquestração mente
Orquestração acrescenta estado. Portanto, acrescenta maneiras novas de estar errado.
Eu aprendi isso implementando status para coding agents. A interface dizia running enquanto Claude Code pedia permissão. Depois de um fork de sessão, o Codex ficou eternamente em ATTENTION. Agentes concluíam tarefas sem produzir a notificação one-shot esperada. Os rótulos pareciam precisos; o comportamento real os contradizia.
A primeira reação poderia ser adicionar mais parsers, interceptar mais sinais e inferir com mais vontade. Fiz o contrário. Tratei como bug de modelagem, mandei refazer a spec e removi tentativas de deduzir estado interno dos providers. Mantive apenas estados justificáveis por fatos do PTY e da UI, como início, execução, saída e situações locais de instalação. Onde a observação não sustentava a promessa, a promessa encolheu.
Esse episódio é o contraexemplo mais importante do artigo. Não existe motivo para trocar a falsa segurança de um chat pela falsa segurança de um dashboard de agentes. Um canvas bonito com cinco avatares “pensando” não é um sistema de engenharia. Pode ser apenas teatro distribuído, agora com linhas conectando as caixas.
Estado confiável precisa ter fonte. Se o provider expõe um evento estável, podemos registrá-lo. Se o terminal só prova que o processo está vivo, podemos dizer que está em execução. Se uma submissão tem resultado ambíguo, o sistema deve manter a ambiguidade e pedir verificação. Inventar “aguardando aprovação” porque uma sequência de bytes parece um prompt de permissão cria uma certeza que o contrato não oferece.
Julgue uma orquestração pelo que ela faz quando não sabe. Se ela esconde incerteza, repete ações externas ou atribui estados internos que não observa, mais agentes apenas multiplicam o raio do erro.
Um estado honesto pode ser menos sedutor. running diz pouco. submission-unknown incomoda. Um hold humano parece atrito. Ainda assim, esses estados permitem uma ação correta. O sistema pode esperar, pedir confirmação ou evitar repetir uma chamada externa. Um rótulo mais específico, porém inventado, conduz automaticamente à ação errada.
Observabilidade útil começa pela origem do fato. Eventos do processo dizem algo sobre processo. O Git diz algo sobre arquivos e commits. O provider diz algo sobre entrega quando oferece um identificador estável. O humano diz algo sobre aprovação. Misturar essas autoridades num único “status do agente” cria uma entidade que ninguém realmente observa.
Isso sugere uma interface menos ambiciosa e mais útil. Em vez de prometer que o sistema sabe se um agente está “pensando”, “bloqueado” ou “aguardando você”, ele mostra fatos: processo vivo, última atividade observada, mensagem entregue, confirmação ausente, arquivos modificados, check executado. A interpretação pode vir depois, com seu grau de confiança explícito. Fato pobre é melhor do que ficção rica.
Também precisamos distinguir automação de decisão. Detectar que o processo saiu com código diferente de zero pode disparar coleta de logs. Não deveria concluir automaticamente que a tarefa falhou, foi cancelada ou precisa ser refeita por outro agente. Essas conclusões dependem do contrato do trabalho e do estado externo. O evento aciona uma investigação; não substitui seu resultado.
17. Release é uma responsabilidade diferente
Gerar um pacote não é promover uma release. Testar em uma plataforma não é testar em todas as plataformas suportadas. Ver um endpoint responder não prova que caches e canais já convergiram. Essas diferenças ficam perigosas quando todo o processo é descrito como “pronto” dentro da mesma conversa.
Num fluxo real, autorizei gerar os packages, mas proibi atualizar o site porque ainda queria testar melhor no Windows e no Linux. Mais tarde, um bug crítico apareceu a tempo de abortar outro candidato. Em outro momento, uma release ruim já estava no canal e determinei uma retirada reversível de stable/latest, preservando tag, artefatos e evidências quando possível. O registro também apontou uma limitação de permissão no purge de cache.
São dois acontecimentos limitados: um candidato abortado e um rollback reversível. Eles não provam que o processo de release é sempre seguro. Mostram por que release precisa de autoridade e estado próprios.
Uma decisão arquitetural do projeto separa prerelease de promoção manual, define gates nativos, comportamento explícito de update/restart e metadados para pausar ou reverter. Isso transforma “acho que está pronto” em uma sequência de decisões observáveis. Ainda pode haver bug. A diferença é que a ação de promover ou recuar não fica implícita na confiança do agente que acabou de empacotar.
Agentes podem preparar artefatos, executar checks, consultar endpoints e montar evidência. Um humano precisa conservar a autoridade para dizer que a evidência é insuficiente, interromper um runner, não promover, retirar do canal ou aceitar um risco conhecido.
Accountability não é o botão apertado no fim. É a obrigação de entender o que o botão muda e de responder quando a mudança dá errado.
Release também expõe o limite da idempotência. Para operações locais, repetir um check costuma ser seguro. Para publicação, promoção de canal ou envio externo, uma resposta ambígua não autoriza retry cego. É preciso verificar o destino, registrar um identificador estável ou manter o trabalho em hold. Caso contrário, uma automação bem-intencionada pode publicar duas vezes enquanto tenta “se recuperar”.
Rollback, por sua vez, não é apagar o passado. Preservar tag, artefatos e evidências permite entender o incidente e impede que a retirada do canal reescreva a história. Reversibilidade boa muda o que os usuários recebem sem destruir o material necessário para corrigir e auditar.
18. A conta rápida do Asaph
O histórico do Asaph oferece um contraste útil, desde que não peçamos a ele uma causalidade que Git não pode provar.
No commit inicial de 5 de março de 2026, o repositório tinha 50 arquivos TypeScript/TSX rastreados e nenhum arquivo de teste ou spec rastreado. Nas rotas amostradas de bands e volunteers, os handlers importavam Prisma diretamente, faziam parse de request.json() sem uma fronteira de validação, definiam shapes inline e chamavam o ORM na própria rota.
Isso descreve a forma do código. Não prova que o aplicativo estava defeituoso. Também não prova por que ele foi escrito assim nem que agentes produziram cada linha.
O que veio depois é mensurável. Em 6 de março, uma migração de Prisma para MikroORM e uma estrutura mais orientada a domínio somaram 9.175 inserções e 2.401 remoções. Em 10 de março, testes de integração e refactoring de serviços acrescentaram 4.388 linhas e removeram 70. Em 15 de março, controllers de aplicação, um DTO comum, adapters mais finos e mais testes trouxeram 3.139 inserções e 1.236 remoções. Em 17 de março, métodos de serviço passaram a receber parâmetros-objeto e o tratamento de erros de API melhorou.
Não somo essas linhas para provar “dívida técnica de vibe coding”. Volume de diff não mede qualidade, e os refactorings podem ter várias causas. Uso o caso para algo menor: escolhas estruturais iniciais foram seguidas, em poucos dias, por mudanças grandes de arquitetura e testes. Implementar rápido tornou barato descobrir o produto; não tornou gratuita a reorganização posterior.
Prototipar assim pode ser a decisão correta. Só precisa ser consciente. Se o objetivo é aprender e o código é descartável, uma rota direta ao ORM talvez seja exatamente o corte adequado. Se o protótipo já está virando produto, ausência de contrato, validação e testes deixa de ser economia e passa a ser uma aposta. O problema não é iterar. É esquecer qual conta ainda está aberta.
Esse limite factual muda a lição. Eu não uso Asaph para condenar protótipos nem para defender uma arquitetura específica. Uso-o para lembrar que geração rápida desloca custo no tempo. A equipe deve decidir quando pagar: antes, com contratos e testes; durante, com revisão incremental; ou depois, com refactoring amplo. Não decidir também é uma decisão, apenas sem orçamento explícito.
19. O contra-argumento merece vencer algumas vezes
Imagine um engenheiro sozinho corrigindo um bug localizado. O agente lê cinco arquivos, reproduz a falha, altera uma função, adiciona um teste e roda a suíte. Tudo cabe numa sessão, a mudança é reversível e o diff é pequeno. Acrescentar SPEC, TESTER, REVIEWER, mensageria, estado durável e um release manager seria desperdício.
Nesse cenário, fique no chat.
Uma boa abstração não exige uso universal. A camada de engenharia aparece quando o custo de continuidade implícita supera o custo de coordenação explícita. Há alguns sinais objetivos:
- uma decisão precisa sobreviver a compaction, troca de modelo ou reinício;
- duas frentes podem tocar a mesma área;
- o resultado exige revisão realmente independente;
- o trabalho atravessa contratos ou plataformas;
- uma ação externa pode ser duplicada ou não pode ser revertida facilmente;
- a promoção depende de autoridade diferente da implementação.
Mesmo com esses sinais, orquestrar pode piorar tudo. Handoffs perdem nuance. Mensagens atrasam. Estados ficam obsoletos. Agentes duplicam arquivos. Um sistema tenta inferir o provider e mente. A solução não é adicionar outra camada que “supervisiona” a primeira até o diagrama parecer uma repartição pública.
Comece pela menor fronteira que resolve o risco. Talvez baste escrever a decisão numa spec. Talvez uma segunda sessão faça o review. Talvez ownership de diretório e uma mensagem de handoff evitem a colisão. Talvez a release só precise de um gate humano explícito. Multiagente não é meta; separação responsável é ferramenta.
O chat continua sendo excelente quando trabalho, responsabilidade e contexto permanecem coerentes. Ele deixa de bastar quando a coerência depende de coisas que a própria conversa não consegue garantir.
Minha heurística é começar sem orquestração e promover uma fronteira somente quando consigo nomear o risco que ela controla. Se preciso preservar uma decisão, crio o artefato. Se preciso de independência, abro outro contexto. Se preciso evitar colisão, declaro ownership e handoff. Se preciso controlar uma consequência externa, adiciono gate e autoridade. A arquitetura cresce em resposta a falhas possíveis, não ao fascínio por uma topologia de agentes.
20. Delegar trabalho não delega autoridade
A engenharia que estou descrevendo não tem um agente central onisciente. Tem responsabilidades delimitadas, artefatos recuperáveis e decisões que deixam rastros.
Uma especificação guarda intenção suficiente para o próximo executor. A implementação muda o repositório, não uma memória privada. Testes registram quais comportamentos foram exercitados e quais ficaram fora. Review produz findings que não se confundem com defesa da solução. Handoffs declaram espera, ownership e retomada. Release preserva a diferença entre gerar, testar, promover, abortar e reverter.
O humano não precisa digitar cada linha para continuar responsável. Precisa decidir o que pode ser delegado, qual evidência satisfaz cada gate, quando a independência é necessária e quem tem autoridade para aceitar risco. Isso não é nostalgia pelo desenvolvimento manual. É governança proporcional ao poder da automação.
Na prática, essa camada pode começar pequena. Uma spec versionada guarda decisões e acceptance criteria. O Git separa as mudanças. Um registro de ownership evita que duas frentes disputem a mesma área. A suíte produz evidência executável. Um review independente escreve findings. Um manifesto diz exatamente o que será promovido. Uma aprovação humana referencia aquele candidato, não uma intenção vaga de “publicar quando estiver pronto”.
Cada peça responde a uma pergunta diferente. O que queremos? O que mudou? Quem pode tocar aqui? O comportamento foi exercitado? Que risco o autor do diff não viu? Qual artefato vai para o usuário? Quem autorizou essa consequência? Tentar responder tudo com “veja a conversa” só funciona enquanto a mesma pessoa, o mesmo modelo e a mesma janela permanecem presentes.
Projetos duram mais do que essa coincidência, e decisões importantes precisam continuar legíveis quando ela termina.
Não há promessa de ausência de processo. Coordenação custa. Revisão custa. Persistir estado custa. O ponto é gastar onde a alternativa é pagar por conflito, reconstrução ou uma ação externa errada. A engenharia tradicional já fazia essa conta; agentes apenas comprimiram o intervalo entre a decisão ruim e sua implementação completa.
Talvez sistemas futuros consigam manter contextos enormes, recuperar qualquer decisão e coordenar dezenas de executores com observabilidade perfeita. Talvez AGI mude radicalmente a distribuição do trabalho. Nenhuma dessas possibilidades elimina a pergunta presente: qual estado é confiável hoje, e quem responde pela decisão tomada com ele?
Minha resposta é menos cinematográfica do que uma sala cheia de agentes autônomos. Persistir o que importa. Separar responsabilidades quando existe um motivo verificável. Dar contexto adequado a cada trabalho. Exigir evidência antes de atravessar gates. Admitir incerteza. Conservar rollback. E manter a autoridade humana onde a consequência é humana.
Chat continuará sendo uma interface valiosa. Só não será o lugar onde a próxima geração da engenharia de software inteira caberá.
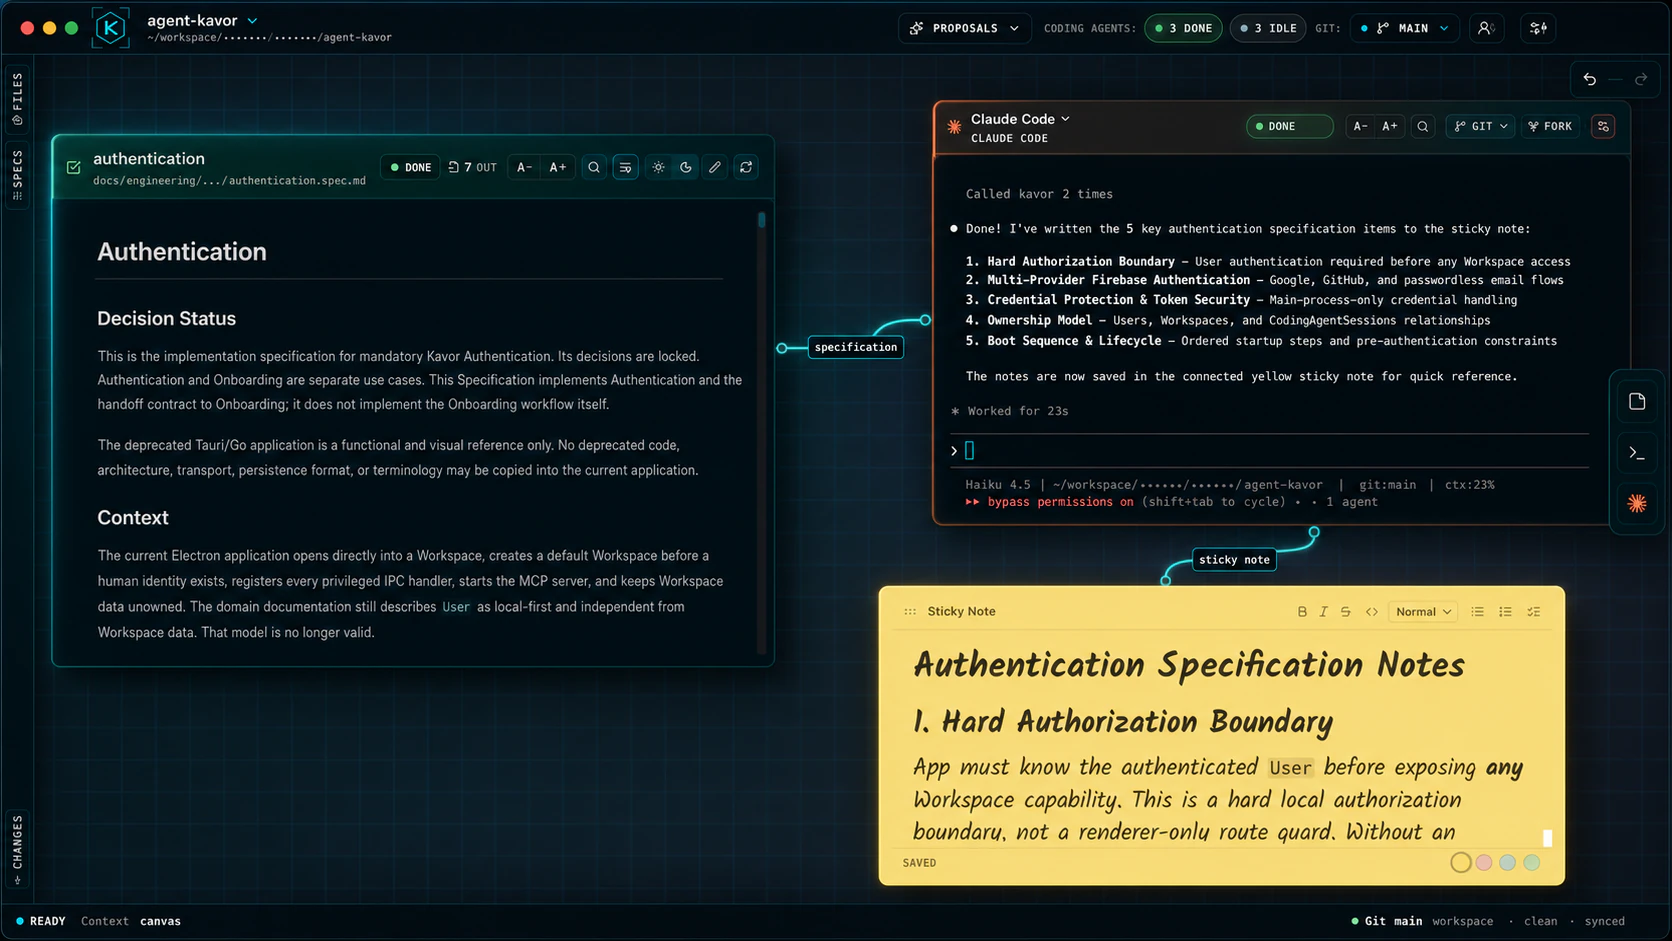
É essa camada de engenharia — ainda em construção, com todas as bordas difíceis que ela merece — que estou tentando criar com o Agent Kavor.
O que este artigo provocou?
Você pode marcar mais de uma opção e desfazer quando quiser.
Comentários
Carregando comentários…