
Ingeniería de software · Inteligencia artificial · Arquitectura de software
La próxima generación de la ingeniería de software no ocurrirá dentro de un chat
Un agente TESTER tenía que reorganizar las pruebas de un sistema sin alterar el comportamiento de su hot pipeline. Otro agente, FIXER, tenía correcciones funcionales pendientes sobre el mismo código. La forma rápida de avanzar parecía evidente: que ambos escribieran y ya resolveríamos los conflictos al final.
Hicimos lo contrario.
FIXER se detuvo. Esperó el mensaje del responsable de las pruebas, mantuvo esa parte de su trabajo como pendiente e indicó qué archivos había tocado para evitar que el otro agente los sobrescribiera. TESTER acotó su territorio a configuración, HTTP, SQLite, pruebas de integración y el nuevo layout externo. Otra responsabilidad conservó el runtime DCMTK. Cuando una prueba resultó incómoda, TESTER no abrió una API de producción solo para facilitarla; eligió un camino de integración real.
Lo interesante no fue que dos chats hablaran entre sí. Fue que existían una propiedad explícita, un límite, una espera deliberada y un handoff que podía comprobarse. La conversación transportó el mensaje. La ingeniería estaba en las decisiones que sobrevivían al mensaje.
Esa escena resume mi tesis: la próxima generación de la ingeniería de software no ocurrirá dentro de un chat. Usará chats, claro. También terminales, editores, repositorios y modelos enormes. Pero su unidad central no será una conversación que aparenta recordar un proyecto entero. Será un sistema de responsabilidades y artefactos duraderos donde la especificación, el código, las pruebas, la revisión, la evidencia y la autoridad de release sigan siendo visibles cuando cambie el contexto o el ejecutor.
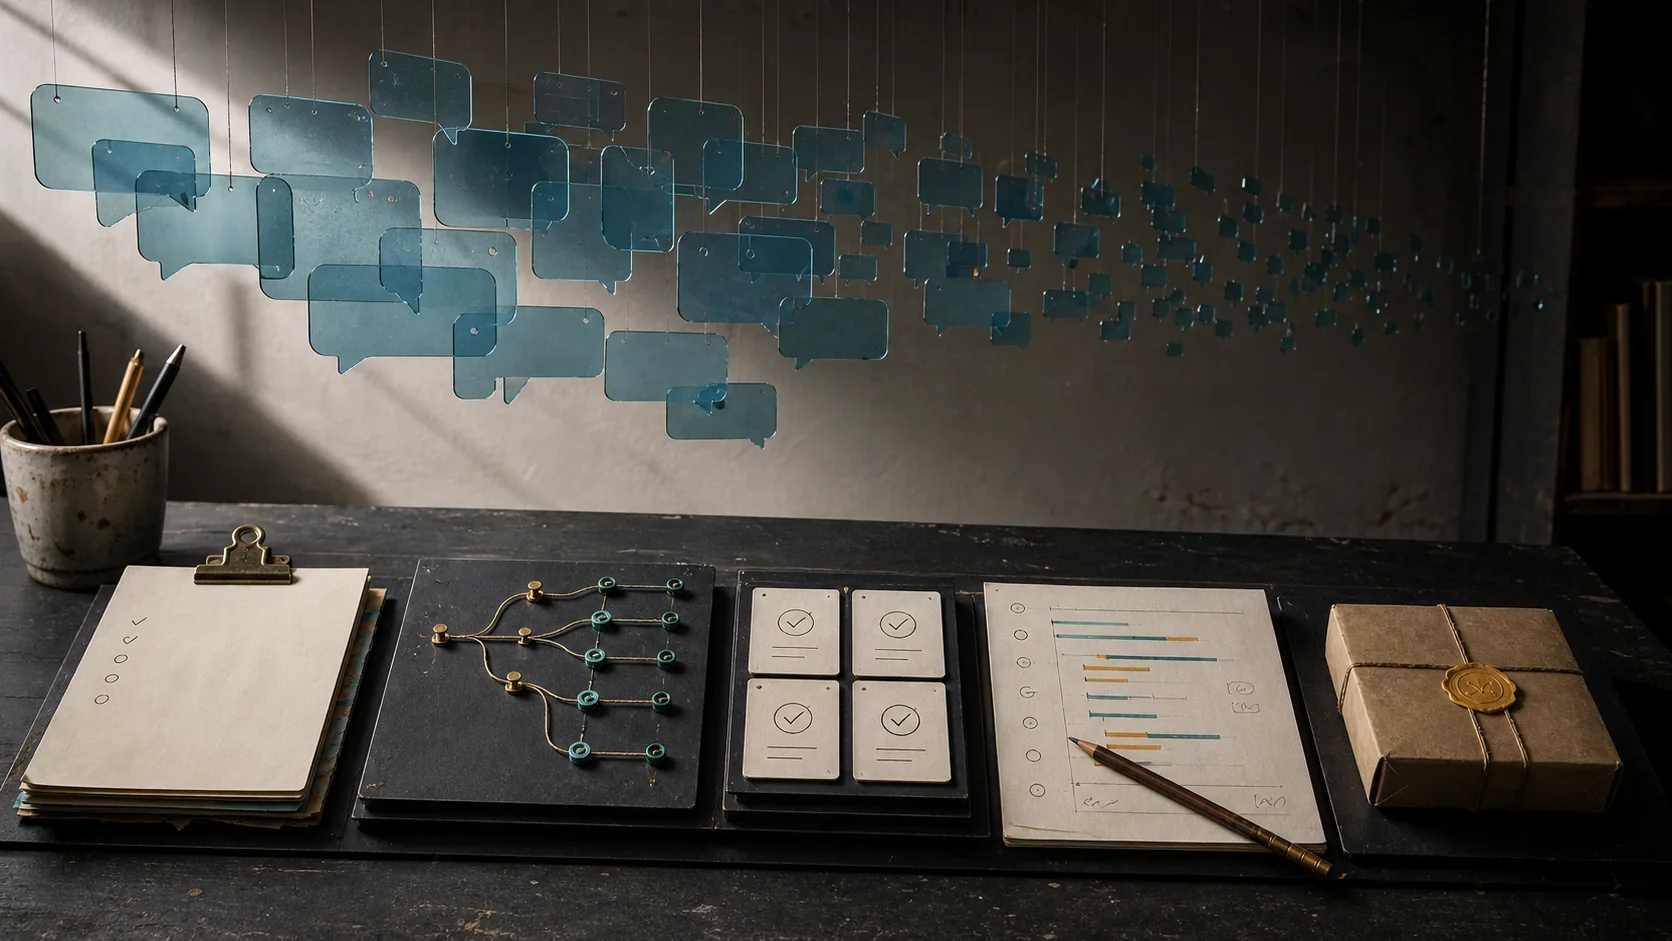
Las conversaciones se disipan; la especificación, el historial, las pruebas, la revisión y la release permanecen.
1. El código se volvió abundante; la ingeniería no
Generar código ya no es la parte escasa de muchos trabajos. Un agente puede recorrer un repositorio, modificar varios paquetes, ejecutar comprobaciones y corregir errores antes de que una persona termine de preparar café. Ese cambio es real y merece entusiasmo. También desplaza el cuello de botella hacia lugares menos fotogénicos.
¿Qué estamos construyendo exactamente? ¿Qué decisión es reversible? ¿Cuál es la fuente de verdad? ¿Quién puede modificar el contrato? ¿Qué evidencia demuestra que el cambio funciona? ¿Quién revisa la solución con independencia? ¿Quién decide que una release puede salir, detenerse o volver atrás?
Producir más código no responde ninguna de esas preguntas. A veces las hace más caras. Una implementación rápida puede extender una decisión débil por más archivos, generar más pruebas alrededor del supuesto equivocado y crear una sensación de avance que vuelve políticamente incómodo retroceder. El agente no inventó este problema. Solo le añadió aceleración.
Por eso digo que la IA hizo abundante el código y escasa la ingeniería. Es una opinión nacida del trabajo, no una medición universal. “Escasa” no significa que antes sobrara. Significa que, cuando el coste marginal de escribir una función cae, crece el valor relativo de decidir cuál función debe existir, cómo encaja, qué no debe hacer y qué prueba aceptaremos.
El error común consiste en envolver toda esa responsabilidad dentro de la misma interfaz que produce el código. Si la conversación contiene el pedido, el análisis, la implementación, las correcciones, los resultados de pruebas y la decisión final, parece que el sistema está completo. En realidad, tenemos una secuencia legible con muchos estados implícitos. Funciona hasta que un estado se pierde, dos trabajos chocan o alguien necesita demostrar por qué una decisión sigue siendo válida.
Un chat puede ser un excelente escritorio. No debería confundirse con la empresa entera.
2. Lo que un chat hace muy bien
Criticar el chat como abstracción principal no exige fingir que es inútil. La conversación es una interfaz extraordinaria para explorar una duda, pedir una modificación local, inspeccionar un error y mantener el hilo de una tarea cohesionada. El lenguaje permite moverse entre intención y detalle sin diseñar una pantalla para cada operación. Esa elasticidad explica buena parte del valor de los agentes actuales.
Las sesiones modernas tampoco son simples cajas de texto. Pueden leer archivos, usar herramientas, ejecutar comandos, recibir sus resultados, crear subagentes y continuar durante muchas vueltas. La propia guía de Anthropic describe cómo el contexto de Claude Code reúne conversación, llamadas y resultados de herramientas y archivos leídos; también recomienda abrir una sesión nueva cuando cambia la tarea. Ambas cosas pueden ser ciertas: la sesión es capaz y su coherencia tiene un límite. La documentación lo presenta precisamente como una cuestión de gestión del contexto.
Si una persona y un agente corrigen un bug pequeño, con un contrato claro, un diff acotado y pruebas rápidas, introducir cinco roles, una cola de mensajes y tres puertas de aprobación sería absurdo. La ceremonia también es deuda. Un flujo que necesita más coordinación que el cambio que coordina ha perdido el argumento antes de empezar.
El chat sigue siendo una buena unidad cuando coinciden tres cosas: una tarea, una responsabilidad y un contexto coherente. En ese caso, la continuidad conversacional ayuda. El problema comienza cuando la pantalla conserva el aspecto de continuidad, pero por debajo cambian la memoria disponible, el modelo que ejecuta, el propósito del trabajo o la autoridad necesaria para avanzar.
Entonces la conversación deja de ser solo una interfaz. Se convierte sin querer en base de datos, bus de eventos, gestor de estado, documento de requisitos, registro de auditoría y consola de release. Es demasiada presión para una lista de turnos, por muy elegante que sea la lista.
3. Una transcripción legible no es memoria de proyecto
Una conversación parece duradera porque podemos desplazarnos hacia arriba. Ese gesto engaña un poco. Lo que ve la persona y lo que el modelo recibe en la siguiente ejecución no son necesariamente la misma cosa. Tampoco toda frase visible tiene el mismo rango: una idea exploratoria, una decisión aprobada y un resultado de prueba pueden quedar mezclados en el mismo flujo sin una marca que diga cuál gobierna.
La memoria de un proyecto necesita contestar preguntas más duras que “¿se dijo esto alguna vez?”. Debe permitir saber qué versión está vigente, quién la cambió, qué otras decisiones dependen de ella, qué evidencia la sostiene y cómo recuperar el estado después de una interrupción. Git responde parte de eso para el código y los documentos. Una suite de pruebas responde otra parte. Un ADR conserva una decisión y su razonamiento. Un manifiesto de release identifica artefactos concretos. Ninguno es perfecto, pero todos hacen explícito algo que el chat suele dejar implícito.
En una especificación que trabajé con agentes, la discusión cambió el contrato y aceptó una migración sin compatibilidad con el concepto anterior. También convirtió criterios de finalización en criterios de aceptación, agregó estados, evidencia, resultados y trazabilidad, y pidió revisiones de código por etapas. El valor no estuvo en conservar cada turno de la discusión. Estuvo en devolver las decisiones al archivo de especificación.
Ese archivo podía recibir un diff, una revisión y una nueva decisión. La conversación ayudó a producirlo, pero dejó de ser la única forma de reconstruir la intención. Ese pequeño cambio de jerarquía importa: el chat propone y transporta; el artefacto autorizado gobierna.
Una memoria de proyecto tampoco tiene que significar un gigantesco documento maestro. Puede ser una red modesta de especificaciones, ADRs, issues, commits, pruebas, hallazgos y recibos. Lo esencial es que los vínculos y la autoridad sean comprensibles. Si la decisión solo existe como una frase enterrada entre dos salidas de terminal, no tenemos conocimiento institucional. Tenemos arqueología futura.
4. El contexto se parece más a memoria de trabajo
Uso una analogía deliberadamente imperfecta: la ventana de contexto se parece más a RAM que a una base de conocimiento de ingeniería. Reúne lo necesario para ejecutar ahora. Puede contener mucho, incluso muchísimo, pero su mera presencia no convierte el contenido en una decisión versionada ni garantiza que el modelo use cada parte con la misma eficacia.
La analogía no describe el mecanismo interno de un modelo. Sirve para distinguir funciones. La memoria de trabajo optimiza la acción presente. La memoria del proyecto debe optimizar recuperación, revisión, conflicto y continuidad a través del tiempo. Una puede alimentarse de la otra; no son intercambiables.
La diferencia aparece en detalles cotidianos. Una sesión puede haber leído veinte archivos y recibir después un gran resultado de pruebas. Todo compite por el presupuesto disponible junto con instrucciones, mensajes y llamadas de herramientas. Si el trabajo continúa, el sistema puede descartar resultados antiguos, resumirlos o sustituir parte del historial. Eso permite seguir, pero no crea una fuente de verdad para el proyecto.
El antídoto no es pegar todo el repositorio en cada prompt. Es decidir qué debe durar y materializarlo en el lugar apropiado. La intención estable entra en una especificación. Una elección arquitectónica entra en un ADR. El cambio entra en Git. El comportamiento esperado entra en pruebas. Un hallazgo entra en una revisión que señala código y severidad. La decisión operativa entra en un estado de release con evidencia.
El agente puede volver a cargar esos elementos. Una persona puede examinarlos sin recrear la sesión original. Otro modelo puede cuestionarlos con un contexto fresco. Esta independencia es el punto. Si para entender el proyecto necesitamos reanimar una conversación exacta, no diseñamos memoria: conservamos una dependencia accidental.
5. Compactar permite continuar, pero también cambia el estado
Cuando una sesión crece, la compactación resuelve un problema práctico: seguir trabajando sin reenviar indefinidamente cada detalle. No hay nada sospechoso en ello. Lo peligroso es tratar la continuidad aparente como si nada hubiera cambiado.
Anthropic explica que su compactación sustituye el historial por un resumen y la califica expresamente como lossy. Su ejemplo muestra un caso en que una advertencia puede omitirse porque la dirección de la tarea siguiente no era predecible. La documentación también distingue la información persistida en archivos, como CLAUDE.md, de instrucciones que solo estaban en la conversación y podrían perderse al compactar. La guía de sesiones describe el problema y sus medidas de control, y el glosario documenta qué se conserva y qué se vuelve a cargar desde disco.
OpenAI describe otra forma. En la Responses API, la compactación puede introducir un elemento cifrado y eficiente en tokens junto con contenido anterior seleccionado para sostener la continuidad. Codex también reemplaza la entrada al superar un umbral por una representación más pequeña. El artículo sobre el entorno de la Responses API explica la compactación nativa, mientras que la explicación del bucle de Codex muestra cuándo entra en juego.
No tenemos base para afirmar que ambas implementaciones pierden la misma información ni de la misma manera. Una se documenta como resumen con pérdida; la otra incluye un objeto opaco pensado para preservar comprensión latente. La semejanza útil es más sobria: en ambos casos existe una transición. El siguiente ejecutor ya no opera sobre una reproducción literal e ilimitada de cada elemento anterior.
Eso basta para una regla de ingeniería: una decisión que debe sobrevivir no puede depender solo de que la compactación la considere relevante. Debe existir fuera del mecanismo de continuidad. No porque la compactación sea mala, sino porque tiene otro trabajo. Su contrato es permitir que la sesión siga. El contrato de un artefacto duradero es permitir que el proyecto pueda demostrar qué decidió.
6. La advertencia que desaparece es más importante que mil tokens conservados
El ejemplo de una advertencia omitida durante una compactación merece atención porque enseña un tipo de fallo, no porque pruebe que todas las sesiones lo sufren. Una frase puede ser secundaria para el objetivo inmediato y decisiva para una tarea futura. Ningún resumen puede optimizar perfectamente para todos los futuros que aún no conocemos.
En ingeniería, muchos detalles tienen esa forma. “No modificar el comportamiento de la hot pipeline” puede parecer una restricción local hasta que otro agente reorganiza pruebas. “Esperar la validación en Windows y Linux” parece un comentario operativo hasta que alguien está a punto de promover una release. “Git es la fuente de verdad” puede ser una preferencia hasta que aparecen dos estados persistentes que divergen.
No necesitamos dramatizar el riesgo. Basta con clasificar la información. Una conversación contiene hipótesis, instrucciones transitorias, resultados voluminosos y decisiones. Compactar todo con el mismo criterio obliga al sistema a adivinar qué tendrá valor más adelante. Materializar las decisiones reduce esa apuesta.
Hay una consecuencia adicional: un resumen puede conservar la conclusión y perder el desacuerdo que le daba límites. “Elegimos X” ocupa menos que “elegimos X porque Y; no aplica si Z; falta comprobar W”. Sin el segundo bloque, otro agente puede usar correctamente la decisión en el caso equivocado. La continuidad verbal se conserva; la frontera conceptual se debilita.
Por eso una buena especificación no solo enumera resultados. Registra criterios de aceptación, excepciones, riesgos abiertos y puertas de revisión. Un buen hallazgo no dice “hay un problema”; señala dónde está, qué consecuencia tiene y con qué severidad. Un buen estado de release no dice “casi listo”; identifica qué pasó, qué falta y quién tiene autoridad para avanzar.
La solución tampoco consiste en guardar cada respiración del agente. Acumular texto sin jerarquía produce un vertedero más duradero, no conocimiento. Hay que conservar lo que cambia decisiones y eliminar la dependencia de una reconstrucción narrativa completa.
7. Cambiar de modelo cambia el ejecutor
La interfaz puede mostrar la misma conversación antes y después de un cambio de modelo. Para la persona, el hilo sigue ahí. Para el sistema, cambió el ejecutor: otro modelo procesa el contexto, con capacidades, costes y comportamiento distintos. En Claude Code, cada modelo utiliza su propia caché de prompts; después de /model, la siguiente petición vuelve a leer la conversación sin aprovechar los aciertos de caché del modelo anterior. Anthropic documenta esa transición en su guía de caché.
Esto no significa que se borre la transcripción. Tampoco que cambiar reduzca necesariamente la calidad. Significa que “la misma conversación” no equivale a “el mismo proceso cognitivo continuado”. La distinción parece filosófica hasta que un flujo asigna responsabilidades distintas a modelos distintos.
En una sesión real, un agente Codex dedicado a especificación solicitó una segunda revisión independiente a una sesión de Claude configurada con esfuerzo xhigh. La evidencia demuestra esa asignación: proveedor distinto, esfuerzo explícito y responsabilidad de revisión. No demuestra que Claude sea universalmente mejor revisor, que xhigh siempre compense ni que el resultado supere a cualquier alternativa.
Lo importante es que la elección puede expresarse como política de trabajo. Una revisión arquitectónica compleja quizá merezca más razonamiento y un contexto fresco. Una transformación mecánica puede preferir menor coste y latencia. Una prueba especializada puede necesitar herramientas concretas. La asignación debería poder evaluarse con cargas representativas, como aconseja también la guía oficial de modelos de OpenAI, en lugar de convertir el nombre de un modelo en una religión de equipo.
Cuando el modelo cambia dentro de un chat, la transición queda disimulada por la continuidad visual. En un sistema de ingeniería, debería ser una decisión observable: quién ejecutó, con qué responsabilidad, sobre qué artefactos y qué evidencia entregó. No para llenar un dashboard de logotipos, sino para saber qué ocurrió cuando el resultado necesita revisión.
8. El argumento más fuerte a favor de contextos mayores
Un contexto mayor puede ser genuinamente mejor. Si una tarea exige comparar muchas partes de un repositorio, seguir una migración transversal o mantener simultáneamente contratos dispersos, dividirla demasiado pronto puede romper relaciones importantes. Las fronteras artificiales también causan errores. Un agente que solo ve un archivo puede corregir el síntoma y dañar el sistema.
Además, la investigación continúa. SubQ, por ejemplo, presenta una arquitectura de atención dispersa y resultados propios de recuperación en contextos largos. Son afirmaciones publicadas por la empresa, sin reproducción independiente establecida en la evidencia de este artículo, pero bastan para rechazar una caricatura: el contexto largo no se ha estancado ni es una vía inútil. Su informe técnico expone esas afirmaciones y sus condiciones.
También tenemos una advertencia histórica. Lost in the Middle, publicado en TACL en 2024, encontró en sus modelos y tareas de preguntas sobre múltiples documentos y recuperación clave-valor que el rendimiento variaba según la posición de la información relevante. A menudo era mejor al principio o al final y peor en el medio; ampliar el contexto no garantizaba usarlo todo igual de bien. El artículo y sus experimentos están disponibles en la ACL Anthology.
Ese trabajo no es un benchmark de los modelos de 2026 ni una prueba sobre mis repositorios. Usarlo para proclamar que “los modelos no entienden contextos largos” sería deshonesto. Su lección duradera es más limitada: capacidad nominal y uso efectivo no son sinónimos. La ubicación, la tarea y el modelo importaron en aquellas evaluaciones.
Mi posición, entonces, no es “menos contexto”. Es “contexto para el trabajo que lo necesita, artefactos para lo que debe durar”. Una inspección transversal puede beneficiarse de una ventana enorme. La decisión resultante sigue necesitando un lugar versionado. Un agente puede leer todo el monorepo para revisar una migración. Sus hallazgos deben señalar diffs, contratos y pruebas que otros puedan comprobar después.
Más memoria de trabajo reduce algunos cortes artificiales. No elimina la necesidad de memoria institucional, del mismo modo que una mesa más grande no reemplaza el archivo del proyecto.
9. Contexto no es conocimiento
Llamo conocimiento de ingeniería a algo que puede recuperarse, cuestionarse y relacionarse con una decisión sin depender de la sesión que lo produjo. No hace falta resolver siglos de epistemología para aplicar esa definición práctica.
Una especificación es conocimiento cuando identifica el contrato vigente y sus incertidumbres. Un commit aporta conocimiento cuando el diff y la historia muestran qué cambió. Una prueba aporta conocimiento cuando expresa un comportamiento y puede volver a ejecutarse. Un ADR aporta conocimiento cuando conserva la decisión, el motivo y las consecuencias. Un hallazgo aporta conocimiento cuando otra persona puede localizar y evaluar el riesgo. La evidencia de release aporta conocimiento cuando permite saber qué artefacto se promovió, qué se comprobó y qué se revirtió.
El contexto es el conjunto que un agente tiene disponible para actuar en un momento. Puede contener esos artefactos, fragmentos de ellos o resúmenes. Su calidad depende de la selección. El conocimiento no “vive” mágicamente en la ventana por haber sido copiado allí; conserva su autoridad porque procede de una fuente identificable.
Esta distinción también protege contra un hábito tentador: pedir al modelo que recuerde una decisión en vez de actualizar el proyecto. “A partir de ahora, usa Git como fuente de verdad” puede funcionar durante la sesión. Si el diseño todavía persiste una copia paralela, el código contradice la conversación. El siguiente agente recibirá una realidad ambigua.
En un episodio concreto, una implementación de ciclo Git para coding agents ya pasaba build, type checks, lint y 94 pruebas. La revisión posterior encontró dos problemas medios y dos bajos. Una de las decisiones resultantes fue rechazar estado duplicado y usar Git como fuente de verdad. El aprendizaje no fue “las pruebas fallaron”: estaban verdes. Fue que la arquitectura necesitaba una autoridad más clara de la que aquellas comprobaciones medían.
Cuando esa elección vuelve al diseño y al código, se convierte en estado de proyecto. Si queda solo en la réplica final del chat, se convierte en una anécdota con fecha de caducidad.
10. Descomponer por decisiones, no por cantidad de agentes
La ingeniería no esperó a los LLM para descubrir que dividir un sistema por pasos visibles suele crear acoplamiento. En su trabajo clásico sobre modularización, David Parnas comparó descomposiciones y defendió ocultar decisiones de diseño susceptibles de cambiar detrás de interfaces. El informe archivado por Carnegie Mellon conserva esa formulación original.
Domain-Driven Design ofrece otra lente. Un bounded context define dónde aplica un modelo, y un context map vuelve explícitas las relaciones entre contextos. La referencia mantenida por Eric Evans resume ambos patrones. Ni Parnas ni Evans prescribieron un agente por módulo o por contexto. Esa extrapolación sería nuestra, y bastante perezosa.
La analogía útil está en las fronteras de responsabilidad. Si dos agentes pueden modificar el mismo contrato sin protocolo, el problema no se resuelve dándoles nombres distintos. Si uno prepara pruebas y otro corrige comportamiento, necesitamos saber quién posee el layout, cuándo ocurre el handoff y qué archivos no deben solaparse. La separación vale porque esconde una decisión y regula una relación, no porque el diagrama ganó otra caja.
También conviene evitar el extremo contrario. Una responsabilidad no equivale necesariamente a una sesión permanente. Un solo agente puede especificar y programar una tarea local cuando la independencia no añade valor. Puede incluso revisar su propio trabajo como primera pasada. La revisión separada se justifica cuando queremos un contexto fresco, reducir el sesgo de confirmar la implementación o aplicar otra especialidad.
Por eso prefiero comenzar con responsabilidades: especificar, implementar, probar, revisar, liberar. Después decido cuántos agentes, sesiones, modelos o personas hacen falta. Empezar por “quiero diez agentes” es arquitectura por coleccionismo. Muy entretenida hasta que hay que depurarla.
Una forma práctica de diseñar el flujo es preguntar, para cada responsabilidad, qué entra, qué sale, qué evidencia debe acompañar la salida y qué decisión sigue reservada a una persona. El resultado de mis casos se parece a esto:
| Responsabilidad | Entrada duradera | Salida verificable | Autoridad humana |
|---|---|---|---|
| Especificación | Problema, restricciones, decisiones previas y ADRs | Contrato, criterios de aceptación, dudas y puertas de revisión | Elegir alcance, compatibilidad y riesgo abierto |
| Coding | Spec y estado conocido del repositorio o worktree | Diff, checks ejecutados, límites y desviaciones | Confirmar dirección y aceptar correcciones arquitectónicas |
| Tests | Contrato y escenarios de regresión | Casos, resultados y fronteras explícitas de cobertura | Decidir si el producto debe cambiar para ser comprobable |
| Revisión | Spec, diff, resultados y contexto independiente | Hallazgos localizables, severidad y evidencia | Aceptar, rechazar o pedir otra solución |
| Release | Artefactos, manifiesto, gates y plan de rollback | Estado de promoción, comprobaciones y recibos | Promover, retener, abortar o revertir |
La tabla no prescribe cinco agentes. Describe cinco contratos de trabajo. En una modificación pequeña, una misma sesión puede cubrir los primeros cuatro y una persona autorizar el quinto. En un cambio arriesgado, cada fila puede requerir contexto independiente, herramientas distintas y un handoff formal. La forma sigue al riesgo.
También ayuda separar el plano conversacional del plano duradero. El primero es donde preguntamos, explicamos y negociamos. El segundo es donde el proyecto conserva el resultado autorizado:
conversación → transición de contexto → acción del agente
      │                    │                    │
      └────────────── escribe o consulta ──────┘
                           │
        especificación · código · pruebas · revisión · release
La flecha inferior es decisiva. Un agente no debería “pasar” una decisión a otro copiando solo una paráfrasis si existe un artefacto autorizado que ambos pueden leer. El mensaje puede indicar qué cambió y por qué requiere atención; la spec, el diff o el hallazgo conserva el detalle. Así el canal de coordinación no se convierte en una segunda fuente de verdad.
El handoff necesita un protocolo mínimo, aunque nadie lo llame protocolo. Debe identificar el trabajo terminado, lo que sigue pendiente, los archivos o componentes afectados, las comprobaciones ejecutadas y cualquier condición que impida avanzar. En el caso TESTER/FIXER, “espera el nuevo layout de pruebas” era una condición real. “He tocado estos archivos” reducía el riesgo de sobreescritura. “Los tests siguen pendientes” evitaba que una implementación parcial pareciera completa.
Hay otra ventaja: un contrato de salida hace que el fallo sea localizable. Si el coding agent entrega un diff correcto pero omite una desviación del contrato, sabemos que falló el handoff de coding. Si el revisor no puede reproducir un hallazgo, falló la evidencia de revisión. Si una promoción queda ambigua, la responsabilidad de release debe congelar el reintento. Sin límites, todos esos fallos se convierten en “el agente se confundió”, una explicación tan cómoda como inútil.
Finalmente, la responsabilidad debe tener permiso negativo: la capacidad de no actuar. TESTER pudo negarse a ampliar una API. FIXER pudo esperar. El revisor puede devolver cero hallazgos en vez de inventar uno para justificar su existencia. Release puede retener un candidato aunque el código haya terminado. Un agente obligado a producir movimiento en cada turno no es autónomo; es una máquina de fabricar trabajo visible.
11. Especificar es producir una entrada duradera
Una especificación útil no es un prompt largo congelado. Es un contrato revisable que separa decisiones tomadas, criterios de aceptación, riesgos abiertos y evidencia pendiente. Su función no es impresionar al agente con contexto. Es impedir que el trabajo cambie silenciosamente de significado.
En el caso de la transformación de Task en Specification, la discusión hizo explícitas decisiones difíciles: el concepto anterior podía desaparecer, el contrato podía cambiar, la migración partía de una base nueva y el nuevo modelo debía incorporar aceptación, estados, evidencia, resultados y trazabilidad. También aparecieron cambios en backlog, canvas y relación con coding agents. Por último, entraron revisiones por etapas.
Ese detalle final importa. La spec no solo describía el estado deseado; definía cómo el trabajo debía ser cuestionado antes de consolidarse. Una puerta de revisión convierte el proceso en parte del contrato. Sin ella, “revisaremos después” significa a menudo “revisaremos cuando el coste de cambiar ya sea molesto”.
La especificación tampoco elimina la conversación. En la práctica, las mejores decisiones surgen al preguntar, comparar y corregir. El archivo recibe el resultado duradero de esa exploración. Si una nueva evidencia cambia el alcance, actualizamos la spec y queda un diff. No necesitamos fingir que la primera intención era perfecta.
Esta forma de trabajar exige cuidado con la autoridad. El agente puede encontrar contradicciones y proponer alternativas. La persona decide si acepta romper compatibilidad, qué riesgo deja abierto y qué coste de migración asume. Delegar la escritura del documento no delega la elección de producto.
Hay una señal sencilla para detectar una spec decorativa: después de leerla, el implementador todavía debe rescatar del chat las decisiones que cambian el código. Si ocurre, el documento no es la entrada del trabajo. Es un resumen ceremonial.
12. Programar es transformar un contrato y dejar una prueba
La responsabilidad de coding empieza con una entrada autorizada y termina con algo más rico que “código escrito”. Debe entregar un diff comprensible, resultados de comprobaciones, límites conocidos y cualquier desviación de la especificación. La implementación es una transformación que otros necesitan inspeccionar.
El episodio de los worktrees lo muestra bien. Se añadieron metadatos Git para los agentes, operaciones de rebase y finalización, validaciones de limpieza, merge de regreso a la rama de origen, eliminación del worktree y abort automático ante conflictos. La sesión reportó build, type checks, lint y 94 pruebas en verde. El repositorio dejó además una historia duradera del cambio.
Ese conjunto permitió formular preguntas precisas. ¿El estado persistido duplicaba algo que Git ya sabía? ¿Qué ocurría si la primera creación del worktree modificaba .gitignore? ¿Cómo debía fallar un merge conflictivo? La revisión no necesitaba confiar en que el agente “recordaba” la intención; podía contrastar spec, diff y comportamiento comprobado.
No convierto un reporte de sesión en verdad absoluta. Los resultados automáticos citados pertenecen a ese episodio y no justifican tasas generales de calidad. Pero sirven para mostrar el formato de salida que quiero: afirmaciones concretas, comandos identificables, alcance y observaciones operativas.
Cuando el coding agent termina solo con una frase optimista, el siguiente responsable debe reconstruir el estado. Cuando entrega artefactos y evidencia, el handoff comienza donde terminó el trabajo anterior. La diferencia no es burocrática. Reduce el espacio en el que dos agentes creen estar trabajando sobre la misma realidad mientras sostienen supuestos distintos.
13. Probar también es una responsabilidad de diseño
El TESTER de la apertura no recibió la tarea genérica de “añadir tests”. Poseía la reorganización del layout externo y escenarios de regresión, bajo una premisa: no cambiar el comportamiento de la hot pipeline. Su alcance se redujo para no chocar con el responsable de DCMTK. Eso ya era diseño de trabajo.
Después apareció una decisión más interesante. Exponer un método de producción como Deserialize habría simplificado una prueba. El agente rechazó ampliar el contrato público solo por esa comodidad y tomó una ruta de integración real. No propongo convertir esta elección local en dogma. Hay ocasiones en que mejorar testabilidad revela una API mal diseñada. Aquí el punto es otro: la prueba no tenía autoridad automática para deformar el producto.
Una responsabilidad de tests necesita dos entradas: el contrato que debe proteger y los riesgos que busca observar. También necesita límites. ¿Qué comportamiento queda fuera? ¿Qué depende de un entorno real? ¿Qué no puede simularse con fidelidad? Sin esas fronteras, una cifra alta de pruebas puede ocultar que todas observan la misma capa cómoda.
Separar TESTER de FIXER creó independencia suficiente para un handoff real. FIXER pudo implementar correcciones funcionales y mantener las pruebas pendientes hasta que existiera el nuevo layout, en vez de crear otra estructura que luego habría que fusionar. No sabemos por la evidencia seleccionada si todo el flujo terminó sin conflictos ni si la entrega final fue superior a cualquier alternativa. Sí sabemos que la pausa evitó un solapamiento consciente.
Eso es lo que debería producir una orquestación: no movimiento constante, sino coordinación que a veces decide esperar. Un dashboard que premia agentes “ocupados” empuja justo en la dirección contraria. En ingeniería, bloquear una modificación hasta recibir el contrato correcto puede ser la acción más productiva del día.
14. Las pruebas verdes no responden la pregunta de la revisión
Build, tipos, lint y pruebas verifican propiedades diferentes. Juntas dan una base fuerte, pero ninguna pregunta automáticamente si elegimos la fuente de verdad correcta, si duplicamos estado o si la solución es más compleja de lo necesario. Esa es una razón concreta para la revisión independiente.
En la implementación de worktrees, las 94 pruebas pasaban cuando pedí revisar el código. La revisión encontró dos cuestiones medias y dos bajas. Después rechacé el estado duplicado, elegí Git como autoridad y autoricé otra simplificación seguida de una nueva revisión.
Sería fácil usar esta historia para vender una regla grandiosa: “la revisión siempre encuentra lo que las pruebas no ven”. La evidencia no permite eso. Es un caso. Algunas revisiones no encuentran nada material; algunas suites sí capturan la regresión decisiva. El valor del episodio está en demostrar que verde y correcto no eran sinónimos para aquella decisión arquitectónica.
La independencia tampoco exige proveedores distintos. Puede ser otra sesión con contexto fresco, otro agente con un mandato específico o una persona que no participó en la implementación. Lo importante es evitar que la revisión herede sin examen todas las conclusiones del autor. Si recibe un resumen que ya declara cada elección inevitable, tendremos una ceremonia de confirmación.
Una buena revisión produce hallazgos accionables y acotados. Señala severidad, mecanismo y evidencia. Puede concluir que no hay problemas. También puede cuestionar la spec, porque una implementación fiel a un contrato equivocado sigue siendo equivocada. Su output debe sobrevivir fuera del chat para que aceptar o rechazar el hallazgo sea una decisión visible.
La persona mantiene esa autoridad. Un agente revisor no veta por decreto. Presenta un caso que puede comprobarse. La ingeniería aparece en la conversación entre evidencia, trade-off y decisión, no en la acumulación de mensajes con tono seguro.
15. Especializar significa asignar recursos a una responsabilidad
“¿Qué modelo es mejor?” suele ser una pregunta mal formada. Mejor ¿para qué responsabilidad, con qué herramientas, bajo qué presupuesto, sobre qué tipo de contexto y con qué criterio de éxito?
La sesión de revisión entre Codex y Claude aporta un ejemplo pequeño pero útil. El agente de especificación solicitó una segunda revisión independiente. La sesión receptora estaba configurada con esfuerzo xhigh. Eso combina responsabilidad, proveedor y nivel de razonamiento. No contiene un experimento controlado. No autoriza a declarar un ganador.
La documentación de Anthropic recomienda asignar modelos distintos según complejidad y coste, y describe cambios entre planificación y ejecución; su guía de costes presenta esa selección como una decisión dependiente de la tarea. OpenAI también expone familias y esfuerzos distintos y aconseja evaluar configuraciones con trabajo representativo. Los nombres, precios, capacidades y límites cambian. La política duradera no debería depender de una tabla de agosto de 2026 copiada en una spec eterna.
Prefiero que el sistema exprese la intención: “segunda revisión arquitectónica con alto esfuerzo y contexto independiente”, “transformación mecánica con latencia acotada”, “prueba de integración con acceso al entorno”, “release sin autoridad para promover”. Después un adaptador decide qué proveedor y configuración cumplen el objetivo disponible hoy.
Esta separación evita dos errores. El primero es usar el modelo más caro para todo, como si más cómputo aboliera el diseño de tareas. El segundo es optimizar cada turno por coste y luego pagar mucho más en coordinación fallida. La unidad económica relevante no siempre es el token; puede ser el ciclo completo hasta una decisión verificable.
Los miles de millones de parámetros no abolieron las responsabilidades. Solo nos dieron ejecutores más capaces para asumirlas. Afortunadamente, seguimos necesitando pensar qué les estamos encargando. Ya era hora de que la arquitectura tuviera algo que hacer.
16. Cuando la orquestación miente
Una historia sobre sistemas multiagente que solo cuenta handoffs exitosos es publicidad. Yo tengo una mejor: intentamos inferir estados internos de coding agents y los estados visibles terminaron contradiciendo el comportamiento observado.
Claude Code pedía permiso mientras la interfaz mostraba running. Una sesión de Codex quedó marcada para siempre como ATTENTION después de un fork. Los agentes terminaban tareas sin producir la notificación puntual esperada. Al principio, podía parecer un problema de ajustar algunas transiciones. La revisión correcta fue más incómoda: el modelo de estado afirmaba cosas que el sistema no podía saber con fiabilidad.
Ordené rehacer la especificación y retirar los intentos de interceptar señales inferidas. El sistema volvió a estados sustentados por hechos de PTY y UI: si el proceso estaba iniciando, ejecutándose o detenido; si la instalación era necesaria, estaba en curso o había fallado. La lista exacta evolucionó durante el refactor, pero la decisión central fue reducir certeza, no maquillarla.
Este episodio es un antídoto contra la fantasía del orquestador omnisciente. Integrar varios proveedores no crea una ontología común de sus estados internos. Si uno expone un evento y otro obliga a deducirlo desde el terminal, mostrar ambos como el mismo WAITING_FOR_USER puede ser una mentira con buen CSS.
La salida no consiste en renunciar a observar. Consiste en distinguir hechos, inferencias y ausencias. Un proceso activo es un hecho local. “El modelo está razonando” puede no ser observable. Un mensaje entregado necesita un identificador y un estado duradero; raspar el terminal y suponer recepción no basta. Una solicitud externa con resultado ambiguo debe detener el reintento hasta verificar qué ocurrió.
La calidad de una orquestación se mide mejor por lo que hace cuando no sabe. ¿Declara incertidumbre? ¿Conserva evidencia? ¿Evita duplicar una operación? ¿Permite reanudar? ¿O transforma señales débiles en una barra de progreso tranquilizadora? Prefiero una interfaz que admita “desconocido” a otra que me informe con precisión imaginaria que todo va al 73 %.
17. Release es otra responsabilidad, no el último mensaje del coder
Terminar una implementación no autoriza promoverla. Parece obvio, pero los flujos conversacionales tienden a comprimir ambos momentos: “las pruebas pasaron, ¿publico?”. Cuando el agente que produjo el cambio conserva todas las herramientas y la conversación empuja hacia el cierre, la fricción entre construir y liberar desaparece justo donde más importa.
En una release real, autoricé generar paquetes, pero prohibí actualizar el sitio porque quería probar mejor en Windows y Linux. Más tarde apareció un bug crítico y abortamos un candidato antes de promoverlo. En otro momento, una versión mala ya estaba en el canal estable; ordené retirarla de forma reversible, preservando la etiqueta, los artefactos y la evidencia siempre que fuera posible. También quedó registrada una limitación de permisos para purgar caché.
Son dos hechos acotados: un candidato abortado y un rollback reversible. No demuestran que todas las releases fueran seguras ni que el flujo pueda operar sin autoridad humana. Demuestran exactamente lo contrario: la autoridad pudo decir “todavía no”, después “detén esto” y finalmente “retira lo promovido sin destruir la evidencia”.
Una responsabilidad de release necesita entradas durables: artefactos identificables, gates, manifiestos, resultados por plataforma, plan de rollback y estado de promoción. Necesita idempotencia porque repetir una publicación después de una respuesta ambigua puede crear duplicados. Necesita separar “construido”, “verificado” y “promovido”. Y necesita un responsable humano para aceptar el riesgo residual.
La conversación puede presentar la decisión. No debe ser el único registro de que ocurrió. Si mañana una persona pregunta qué versión estuvo disponible, qué comprobación faltó o por qué se retiró, la respuesta no puede depender de encontrar el turno correcto en una sesión compactada.
También hay una consecuencia cultural. Cuando release es una responsabilidad explícita, “he terminado mi código” deja de significar “el producto está listo”. Esa modestia semántica evita bastantes aventuras operativas.
El flujo operativo debería conservar al menos cuatro momentos distintos. Primero se construye un candidato a partir de una revisión identificable del repositorio. Después se valida en los entornos que el riesgo exige. Luego una persona decide si lo promueve. Por último, el sistema comprueba el estado público y registra un recibo. Si mezclamos esos pasos en un comando opaco, una respuesta a medias puede dejar al equipo sin saber si debe repetir, revertir o esperar.
La idempotencia importa precisamente allí. Imaginemos que la plataforma acepta una petición de promoción, pero la conexión cae antes de devolver una respuesta. Repetir de inmediato quizá publique dos veces o sobrescriba un estado que ya cambió. Declarar fallo quizá sea falso. El estado correcto es ambiguo: hay que verificar el destino antes de autorizar otra acción. Una conversación puede describir esta cautela, pero el bloqueo debe existir en el workflow y sobrevivir a un reinicio.
La reversibilidad tampoco equivale a borrar. En el rollback mencionado, preservar la etiqueta y los artefactos permitía conservar la historia mientras se retiraba la versión del canal estable. El objetivo operativo era dejar de anunciar una release mala, no fingir que nunca había existido. Esa diferencia protege la auditoría y facilita investigar el fallo.
Los gates deben ser igualmente concretos. “Está probado” no basta si la promoción se había retenido para validar Windows y Linux. “Pasó en mi máquina” no sustituye el resultado pendiente. “El sitio parece actualizado” no identifica qué artefacto sirve. Cada gate necesita una evidencia que responda a la razón por la que fue creado. De lo contrario, el workflow solo añade casillas.
Finalmente está el derecho a detenerse. Una release puede esperar aun cuando todos los agentes estén satisfechos. Puede abortarse después de encontrar un bug crítico. Puede requerir rollback aunque preservar evidencia resulte menos limpio que borrar. El sistema debe convertir esas decisiones humanas en estado efectivo, no tratarlas como comentarios que otro agente puede reinterpretar en el siguiente turno.
Esta separación no vuelve segura cualquier entrega. Un gate puede estar mal diseñado, una comprobación puede ser insuficiente y una persona puede equivocarse. Lo que ofrece es algo más modesto y útil: un lugar donde localizar la decisión, la evidencia disponible y el punto exacto en que el riesgo fue aceptado. Sin eso, la historia de una release se reduce a una secuencia de mensajes optimistas seguida, a veces, por uno escrito en mayúsculas.
18. La factura de iterar sin fronteras
Asaph ofrece un caso limitado de por qué generar rápido no equivale a consolidar bien. El primer commit verificado tenía 50 archivos TypeScript/TSX, no incluía archivos de pruebas o specs rastreados y mostraba rutas de bands y volunteers que importaban Prisma directamente, analizaban request.json() sin una frontera de validación y llamaban al ORM desde los handlers.
Nada de eso, por separado, demuestra que la aplicación fuera defectuosa. Un prototipo puede aceptar esas decisiones para aprender. Una ruta pequeña puede no necesitar una arquitectura ceremonial. Tampoco la historia de Git demuestra quién escribió cada línea ni permite afirmar que todo fuera producto de “vibe coding”.
Lo que sí demuestra es la secuencia posterior. Al día siguiente llegó una migración de Prisma a MikroORM y una estructura orientada al dominio, con 9.175 inserciones y 2.401 eliminaciones. Días después entraron pruebas de integración extensas y refactors de servicios, con otros 4.388 añadidos. Luego aparecieron controladores de aplicación, un DTO común, adaptadores más delgados y más pruebas, seguidos por cambios en parámetros de servicios y manejo de errores.
Uso esos números como tamaño de los cambios registrados, no como medida de desperdicio. La evolución pudo ser razonable y necesaria. El aprendizaje práctico es que una primera estructura abundante crea superficie de cambio. Si las fronteras de validación, dominio y persistencia llegan después, iterar sigue siendo posible, pero la factura se reparte por muchas capas.
La alternativa no es diseñar durante seis meses antes de crear una ruta. Es hacer explícita la naturaleza del experimento. ¿Qué parte es descartable? ¿Qué contrato creemos estable? ¿Qué riesgo aceptamos por no tener tests? ¿Qué evidencia nos hará cambiar la estructura? Una spec breve puede contener esas respuestas. Un prototipo etiquetado puede tener permiso para ser feo. Lo peligroso es que la velocidad borre la diferencia entre aprender y consolidar.
Los agentes reducen el coste de la gran refactorización. Excelente. También reducen el coste de producir la primera masa de código que la vuelve necesaria. Sin responsabilidad sobre las decisiones, ambas curvas bajan y seguimos sin saber si avanzamos.
19. El contraargumento: a veces el sistema sobra
La objeción más fuerte a mi tesis no es que el chat sea perfecto. Es que una capa adicional de ingeniería puede empeorar el trabajo. Más artefactos crean más sincronización. Más agentes crean más handoffs. Los handoffs pierden contexto. Las colas añaden latencia. Los estados se desactualizan. Los permisos bloquean operaciones. Y, como mostró el fallo de inferencia, el propio orquestador puede fabricar una visión falsa.
Estoy de acuerdo.
Para una tarea pequeña y cohesionada, mantendría una conversación. Si hace falta inspeccionar una base amplia, usaría un contexto mayor. Si una persona puede revisar el diff con rapidez, no construiría un parlamento de agentes. Si el cambio es barato de revertir y su evidencia es inmediata, reduciría las puertas.
Introduciría separación cuando aparezca una razón concreta:
- una decisión debe sobrevivir a sesiones, compactaciones o cambios de modelo;
- dos trabajos pueden tocar el mismo territorio y necesitan propiedad;
- una prueba requiere independencia respecto de la implementación;
- una revisión debe cuestionar el marco mental del autor;
- una operación externa puede quedar en estado ambiguo;
- promover o revertir exige autoridad distinta de la que escribió el cambio.
La granularidad también importa. No propongo un agente por archivo ni un workflow BPMN para corregir un typo. Una responsabilidad puede agrupar muchas acciones, y un agente puede asumir varias responsabilidades cuando no hay conflicto de intereses o necesidad de contexto fresco.
El objetivo no es maximizar agentes. Es minimizar estado implícito en trabajos donde ese estado puede causar daño. A veces el resultado óptimo será un chat, un diff y una prueba. Otras veces será una spec, dos agentes coordinados, revisión independiente y un gate humano de release. La arquitectura se gana con el problema; no viene incluida en la moda.
También debemos medir el orquestador por su mantenimiento. ¿Cuánto cuesta adaptar proveedores? ¿Qué ocurre después de un reinicio? ¿Los mensajes tienen entrega duradera? ¿Los reintentos son seguros? ¿Se puede explicar una decisión sin la interfaz? Si esas respuestas son peores que el flujo manual, el sistema todavía no merece gobernar el trabajo.
En la práctica uso un umbral sencillo. Primero intento resolver la tarea en una sesión y con artefactos normales del repositorio. Si la conversación sigue cohesionada, el diff permanece acotado y las pruebas responden la pregunta importante, no añado más piezas. La separación aparece cuando detecto una transición que no quiero dejar implícita: otra especialidad, otra fuente de autoridad, una comprobación independiente o una operación con consecuencias externas.
Ese umbral evita confundir complejidad accidental con madurez. Un sistema puede enviar mensajes entre veinte agentes y continuar dependiendo de un texto libre para saber si una prueba terminó. También puede usar una sola sesión y ser riguroso porque la spec, el diff, las pruebas y la aprobación están claros. La arquitectura visible importa menos que los contratos que realmente sobreviven.
Conviene revisar el flujo con preguntas hostiles. Si un agente desaparece después de modificar archivos, ¿otro puede recuperar el estado sin adivinar? Si la compactación omite una advertencia, ¿la restricción sigue en la spec? Si el proveedor responde de forma ambigua a una publicación, ¿el sistema evita repetirla? Si dos modelos interpretan de modo distinto una decisión, ¿existe un artefacto autorizado para resolver el desacuerdo? Si una persona rechaza una release, ¿ese “no” bloquea de verdad el siguiente paso?
Cada respuesta negativa revela dónde el chat está desempeñando una función que no debería poseer. No siempre hace falta construir una plataforma. A veces basta con actualizar el documento, registrar un estado o exigir un identificador estable. El movimiento relevante es sacar la decisión de la memoria circunstancial y darle un contrato proporcional a su coste.
También hay que retirar arquitectura cuando deja de justificarse. Si una frontera nunca produce independencia, si dos roles siempre avanzan juntos o si una cola solo duplica el estado de Git, simplificar es una mejora. El objetivo no es defender el sistema que diseñamos. Es conservar la menor estructura capaz de hacer explícitas las decisiones que no podemos permitirnos perder.
20. Delegar trabajo no delega autoridad
La ingeniería con agentes necesita una separación que a veces incomoda: los agentes pueden ejecutar trabajo de ingeniería; la responsabilidad final no se evapora. Una persona o una organización sigue eligiendo el producto, aceptando trade-offs, evaluando riesgo y autorizando la release.
Esto no reduce al agente a un autocompletado. En los casos descritos, los agentes modificaron especificaciones, implementaron una integración Git, reorganizaron pruebas, hicieron revisiones independientes, detectaron problemas y ejecutaron acciones operativas. Es trabajo sustantivo. Precisamente por eso requiere entradas, fronteras y evidencia dignas de ingeniería.
La autoridad humana tampoco debe ser un botón ritual. Para decidir necesita ver qué se construyó, qué pasó las pruebas, qué halló la revisión, qué sigue incierto y qué operación será reversible. Una aprobación sin ese contexto es una firma decorativa. Un sistema serio presenta la decisión y conserva su resultado.
¿Cambiaría esto con una inteligencia mucho más capaz? Tal vez cambiaría cuánto trabajo podemos delegar, pero no tenemos evidencia aquí para predecir una AGI ni para declarar abolida la responsabilidad sobre un producto que afecta a otras personas. Esa discusión puede esperar; ya tenemos suficientes problemas verificables en los releases del martes.
La forma positiva de la tesis es sencilla. Conservemos el chat como una interfaz flexible. Demos a cada trabajo el contexto que necesita. Usemos modelos y esfuerzos distintos cuando la responsabilidad lo justifique. Pero saquemos del flujo efímero todo lo que debe gobernar el proyecto: intención, decisiones, código, pruebas, hallazgos, mensajes duraderos, estados de entrega y evidencia operativa.
Entonces una compactación será una transición de memoria de trabajo, no una amnesia institucional. Un cambio de modelo será una reasignación visible, no una continuidad fingida. Un handoff podrá detener el trabajo en vez de producir una colisión. Una suite verde será evidencia importante, no absolución arquitectónica. Y una release seguirá esperando a la persona que puede decir sí, no o todavía no.
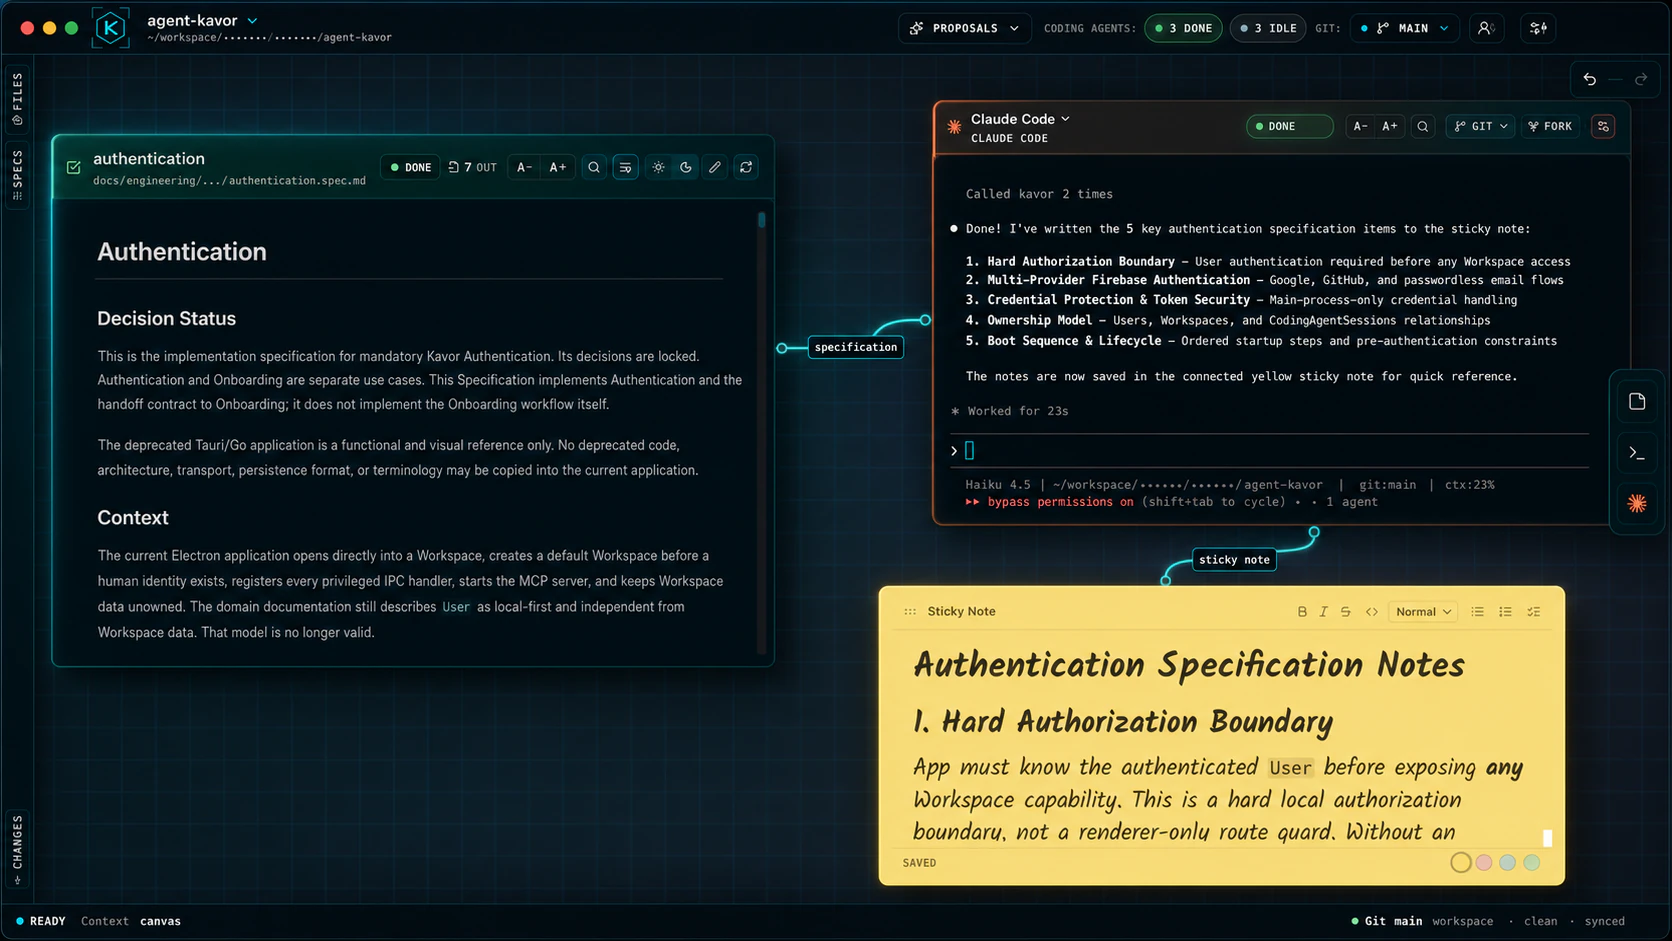
Eso es lo que estoy intentando construir con Agent Kavor.
¿Qué te provocó este artículo?
Puedes elegir más de una opción y deshacerla cuando quieras.
Comentarios
Cargando comentarios…