
Ingeniería de software · Inteligencia artificial · Arquitectura de software
Pasé horas especificando una funcionalidad con agentes y cambié el requisito
Pasé horas especificando una funcionalidad con agentes. Todavía no había escrito una línea de implementación y el requisito ya no era el mismo.
Eso fue lo valioso.
La petición inicial describía un componente local, multiplataforma y aparentemente sencillo. En vez de pedir código, escribí algo parecido a: «entrevístame para recoger los requisitos, entender la infraestructura y definir la solución y el stack». La entrevista empezó a tirar de cada hilo: integraciones externas, seguridad, cargas grandes, concurrencia, instalación, actualizaciones, recuperación ante fallos, observabilidad y ciclo de vida.
Lo que parecía una pequeña utilidad empezó a comportarse como lo que realmente era: un sistema de producción con límites que todavía no habíamos decidido.
El prompt que uso antes de pedir código
Mi versión reutilizable es esta:
Entrevístame para detallar esta funcionalidad antes de escribir código. Cubre requisitos funcionales y no funcionales, arquitectura, integraciones, stack, seguridad, operación, fallos, pruebas y rollout. No preguntes lo que ya esté claro. Separa decisiones, recomendaciones, dudas reales y puntos que necesiten una prueba.
No es un prompt mágico. Si el contexto es pobre, las preguntas también lo serán. Su utilidad está en cambiar la tarea del agente: deja de intentar completar código cuanto antes y empieza a buscar las decisiones que faltan.
También le doy acceso al repositorio, explico el resultado esperado, marco lo que no forma parte del alcance y enumero las restricciones que no puede cambiar. Después respondo rápido, casi siempre en bullets: sí, no, una decisión corta o recomienda cuando quiero que compare alternativas.
La siguiente ronda no vuelve a empezar. Le pido que actualice una especificación duradera, señale contradicciones y pregunte solo por indecisiones que puedan cambiar el diseño o la implementación.
Las preguntas cambiaron varias decisiones
En este caso no fue una entrevista decorativa. Cambió decisiones concretas:
| Supuesto inicial | Lo que la entrevista puso bajo presión | Decisión después del análisis |
|---|---|---|
| «El componente es sencillo» | Integraciones, escala, ciclo de vida, actualizaciones y recuperación | Tratarlo como un sistema de producción con límites explícitos |
| El primer stack recomendado era suficiente | La concurrencia pesada pasó a ser una restricción dominante | Volver a comparar y cambiar la recomendación de stack |
| Más módulos parecían dar más seguridad | Varias separaciones solo anticipaban una complejidad que aún no existía | Mantener una base más pequeña |
| Bastaba con cerrar después de un tiempo inactivo | Un proceso externo podía volver a pedir trabajo más tarde | Vincular el ciclo de vida al trabajo y a los procesos reales |
| Una especificación larga significaba que todo estaba listo | Tres riesgos aún dependían de contratos, spikes o pruebas reales | Implementar la base y comprobar aparte los riesgos pendientes |
Yo también tuve que cuestionar al agente. No acepté el primer stack solo porque la recomendación sonaba segura. Frené una división en módulos que estaba creciendo antes de demostrar su valor. Y cuando una regla de cierre por inactividad podía interrumpir trabajo tardío, pedí revisar el supuesto.
El agente amplió mi campo de visión; no tomó posesión de la ingeniería. Esa diferencia importa.
Plan mode ayuda, pero sigo prefiriendo preguntas y respuestas
Plan mode mejora mucho la experiencia cuando el agente necesita inspeccionar contexto, presentar preguntas por etapas y confirmar decisiones antes de avanzar. En aquella sesión le pedí que regenerara doce preguntas en Plan mode y la interacción quedó más ordenada.
Hoy, para entrevistas largas, prefiero una lista común de preguntas y respuestas. Puedo escanearla rápido, responder varios puntos juntos, anotar una excepción y conservar el bloque como artefacto. No son métodos rivales. Plan mode organiza mejor la conversación; los bullets me dan más velocidad cuando ya estoy metido en el problema.
Esta forma de trabajar no es una rareza aislada. Codex, el Plan mode de Claude Code y los planes revisables de Google Antigravity permiten analizar y corregir el plan antes de programar.
Sí, el agente puede generar cien dudas :)
En otra especificación, esta vez de Agent Kavor, pedí las cien preguntas que seguían abiertas entre varias specs y decisiones de arquitectura. Añadí dos reglas: no preguntar lo obvio ni repetir lo que ya estaba decidido.
El agente entregó las cien. Yo las respondí en bloques y usamos las respuestas para cerrar decisiones dispersas en especificaciones y registros de arquitectura.
Funcionó, pero el número no es el método. Cien preguntas genéricas son cien interrupciones. Lo útil fue obligar al agente a leer primero los artefactos existentes y concentrarse en vacíos que podían cambiar el diseño, el contrato o la implementación.
Para que una ronda así no se vuelva absurda, uso estos filtros:
- descartar lo que el repositorio o la spec ya responden;
- ordenar las dudas por el coste de equivocarse;
- separar hechos, recomendaciones y suposiciones;
- pedir contraejemplos y modos de fallo;
- marcar qué necesita una fuente, un contrato o un spike;
- devolver cada decisión al documento, no dejarla perdida en el chat.
El agente no reemplaza la prueba
El argumento más fuerte contra este proceso es justo: puede convertirse en teatro de análisis. Es fácil confundir una conversación larga con profundidad. Un modelo puede inventar un caso límite improbable, repetir la misma duda con otras palabras o dibujar una arquitectura impecable para un problema que no existe.
Por eso no mido la calidad de la spec por páginas ni por cantidad de preguntas. Pregunto: ¿qué decisión cambió?, ¿qué contradicción desapareció?, ¿qué riesgo quedó delimitado?, ¿qué todavía exige evidencia?
Si una duda cuesta menos de comprobar que de discutir, hago el experimento. Si la integración depende del comportamiento de un tercero, busco el contrato o pruebo el entorno real. Si una abstracción no responde a una variación conocida, la elimino. Y si el agente afirma algo con seguridad sin poder demostrarlo, la afirmación sigue siendo una hipótesis.
La última revisión de mi caso no dijo «todo listo». Separó una base implementable de tres puertas de evidencia. Para mí, esa es una señal de una especificación madura: sabe dónde termina la decisión y empieza la incertidumbre.
Un modelo más capaz compra espacio para pensar
Para decisiones de alto impacto, he preferido usar el modelo más capaz que tengo disponible y subir el nivel de reasoning. Cuesta más tiempo y tokens. En compensación, puede mantener más restricciones en juego, comparar más alternativas y seguir una cadena de consecuencias más larga.
En mi experiencia, la sensación es de multiplicar por diez mi capacidad de abstraer y analizar. Es una percepción personal, no un benchmark. Tampoco significa diez veces más productividad ni diez veces menos defectos. Significa que consigo someter muchas más hipótesis a presión antes de convertir una mala decisión en código.
Codex ofrece niveles de esfuerzo hasta xhigh; Claude Code permite ajustar el effort en modelos compatibles; y Google Antigravity expone variantes con distintos niveles de razonamiento. Ayudan con problemas complejos; no emiten un certificado de corrección.
La ingeniería de software sigue siendo soberana. El agente no conoce por arte de magia el negocio, no asume la responsabilidad por seguridad y no decide qué trade-off acepta el equipo. Yo aporto el contexto, cuestiono las recomendaciones, exijo evidencia y decido cuándo ya podemos implementar.
Las especificaciones están volviendo al centro
No demuestran un flujo universal, pero la convergencia está documentada. GitHub Spec Kit organiza especificación, plan, tareas e implementación; Kiro Specs mantiene requisitos y diseño como artefactos revisables; Claude Code puede investigar y proponer sin editar; y Google Antigravity produce planes y otros artifacts para revisión.
La dirección práctica es clara: si un agente puede producir código muy rápido, conviene darle una especificación que sobreviva al prompt y pueda ser cuestionada.
La investigación sobre ingeniería de requisitos también trata los LLM como apoyo para elicitar, analizar, especificar y validar requisitos, no solo como generadores de implementación. Un estudio con 55 profesionales encontró una preferencia clara por la colaboración entre personas e IA frente a la automatización completa. Es una muestra pequeña, no una medida universal, pero encaja con lo que he encontrado en la práctica.
También hay límites abiertos. Una revisión sistemática de la literatura señala problemas de reproducibilidad, control y validación. Justamente por eso el buen uso no consiste en obedecer al modelo, sino en diseñar un loop que obligue a contrastar sus conclusiones.
Agent Kavor viene en esa dirección
Esta es también una de las ideas detrás de agentkavor.com, que viene en camino. Quiero sacar este proceso de una conversación lineal: trabajar la spec de forma visual, conectar artefactos y agentes en un grafo, y dejar que Agent Kavor coordine la implementación, las salidas y la trazabilidad.
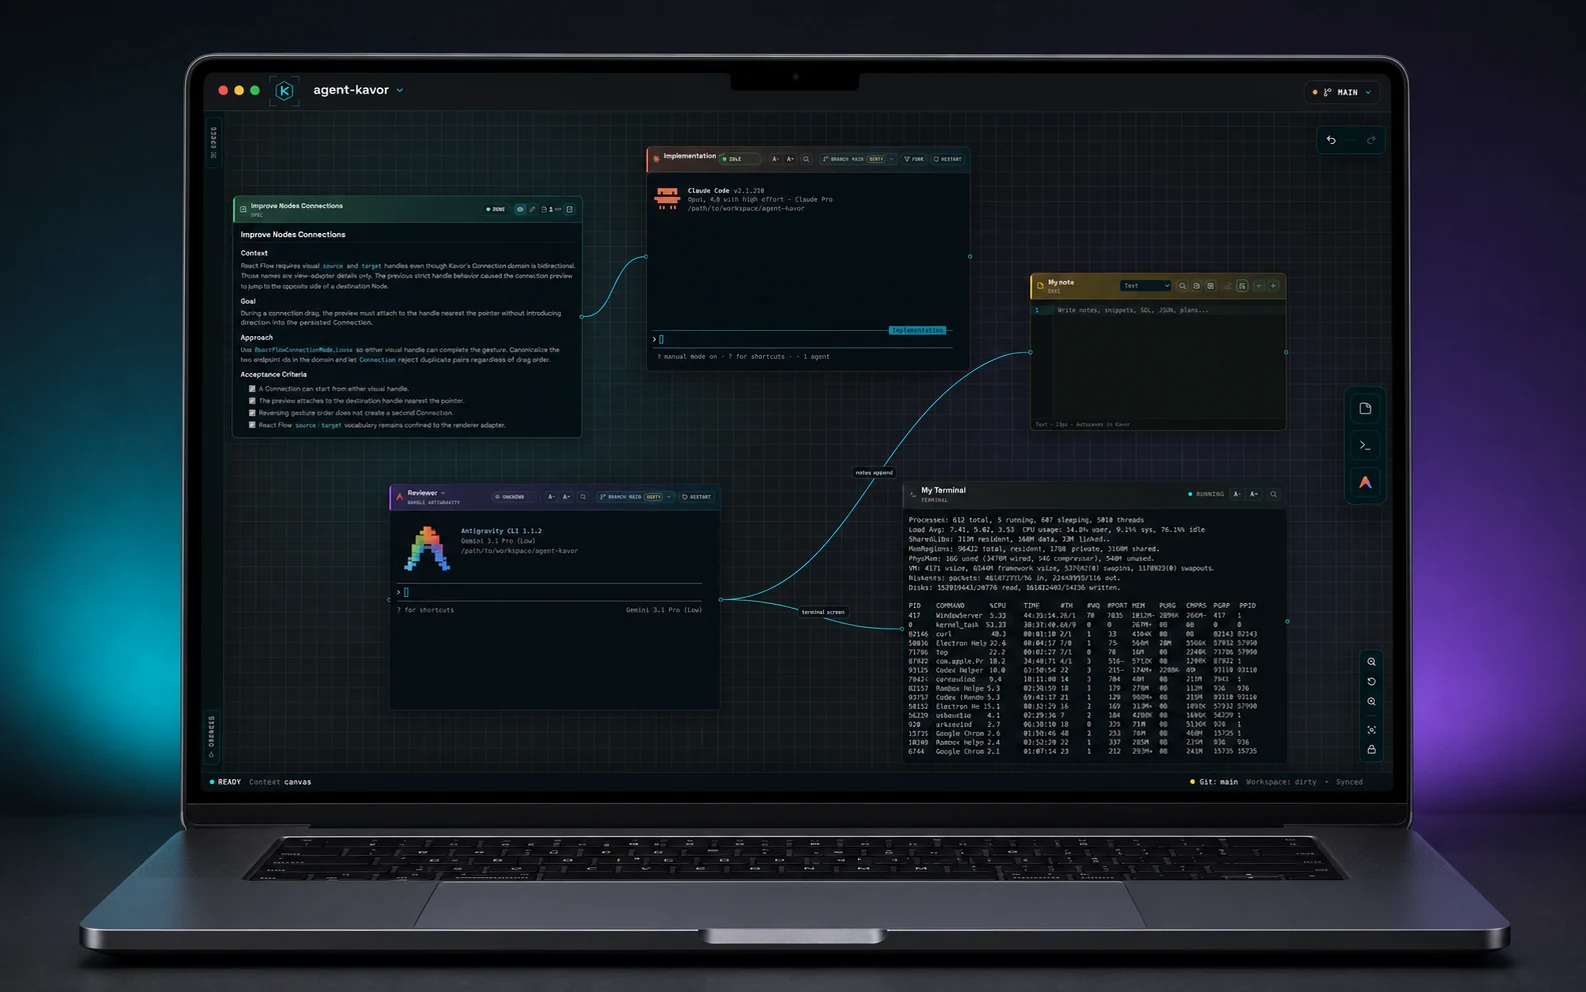
Un pequeño adelanto de Agent Kavor: specs, agentes y outputs conectados en el mismo canvas.
Mi requisito cambió antes de que existiera código porque la entrevista hizo visible lo que la primera petición ocultaba. Ese es el uso de agentes que más me interesa ahora: no programar más rápido una decisión frágil, sino llegar al código con menos cosas importantes sin pensar.
¿Qué te provocó este artículo?
Puedes elegir más de una opción y deshacerla cuando quieras.
Comentarios
Cargando comentarios…