
Engenharia de Software · Arquitetura · Inteligência Artificial
Passei horas especificando uma feature com agentes — e terminei mudando o requisito
Passei horas especificando uma feature sem escrever uma linha de código. No final, descobri que o requisito inicial estava errado.
Ótimo resultado :)
A feature parecia simples: um componente local, multiplataforma, responsável por coordenar aplicações externas e esconder complexidade do usuário. Eu já tinha uma ideia de fluxo e queria definir a infraestrutura e a stack para começar a implementação.
Em vez de pedir código, escrevi algo próximo disto:
Me entreviste para detalhar esta feature antes de escrever código. Cubra requisitos funcionais e não funcionais, arquitetura, integrações, stack, segurança, operação, falhas, testes e rollout. Não pergunte o que já estiver claro. Separe decisões, recomendações, dúvidas reais e pontos que exigem prova.
Esse é o meu “prompt mágico” atual. Não porque ele produza respostas mágicas, mas porque muda o papel do agent. Em vez de adivinhar uma solução e correr para implementá-la, ele começa tentando encontrar o problema que ainda não descrevi direito.
Foi exatamente o que aconteceu.
A feature simples começou a ficar parecida com um sistema real
A primeira rodada abriu perguntas sobre fluxo do usuário, integrações externas, autenticação, grandes volumes, concorrência, suporte a sistemas operacionais, instalação, atualização, recuperação de falhas, observabilidade e ciclo de vida.
Nenhum desses temas é exótico. O curioso é como eles somem quando a descrição começa com “o objetivo é simples”. Simples para quem? Em qual caminho? Com qual volume? O que acontece quando a aplicação externa demora, fecha ou volta depois?
Durante as entrevistas, quatro decisões importantes mudaram antes de virarem código. E o limite do que estava pronto para implementar ficou mais claro:
| Suposição inicial | Pressão da entrevista | Decisão depois da análise |
|---|---|---|
| “O componente é simples” | Integrações, escala, ciclo de vida, atualização e recuperação | Tratar como um sistema de produção com fronteiras explícitas |
| A primeira stack recomendada parecia suficiente | A concorrência pesada virou a restrição dominante | Reavaliar e mudar a recomendação de stack |
| Mais módulos pareciam deixar a solução mais segura | A divisão começou a antecipar abstrações que ainda não existiam | Manter uma fundação menor |
| Encerrar depois de um período ocioso parecia razoável | Trabalho externo podia chegar mais tarde | Ligar o ciclo de vida a processos e trabalho realmente ativos |
| Uma spec longa parecia significar “pronto” | Três riscos ainda dependiam de contratos, testes ou ambiente real | Implementar a base e fazer spikes para o restante |
O agent não fez isso sozinho. Eu contestei a primeira recomendação de stack. Também parei uma arquitetura que começava a criar módulos demais e questionei uma regra de encerramento que poderia interromper trabalho tardio.
Essa é a parte que mais me interessa: o agent amplia o campo de análise, mas a engenharia continua decidindo. A boa especificação nasceu do atrito entre as perguntas dele e as minhas objeções.
“Me entreviste” é só o começo
Se eu entregar duas frases vagas, o agent pode produzir cinquenta perguntas igualmente vagas. O contexto vem antes da entrevista: objetivo, repositório, restrições conhecidas, integrações existentes e o que definitivamente não faz parte da feature.
Depois, peço que ele percorra áreas diferentes:
- resultado esperado, atores, fluxos e critérios de aceitação;
- comportamento funcional, estados e transições;
- desempenho, volume, latência, disponibilidade e recuperação;
- segurança, privacidade, segredos e limites de autorização;
- arquitetura existente e restrições que não podem ser ignoradas;
- integrações, contratos, versões e comportamento quando algo externo falha;
- alternativas de stack e qual restrição deve comandar a escolha;
- instalação, migração, atualização, rollback e suporte;
- observabilidade, testes e dúvidas que exigem um spike.
Eu respondo rápido. Sim, não, uma frase curta ou recomende quando quero que o agent apresente uma escolha fundamentada. Depois peço que atualize a spec, liste contradições e volte apenas com as indecisões que realmente alteram design ou implementação.
No fim da rodada, uma pergunta ajuda muito:
O que está implementável agora, e o que ainda depende de evidência?
Essa pergunta evita uma confusão comum: documento completo e conhecimento completo não são a mesma coisa. Uma API externa, um comportamento de sistema operacional ou um limite de desempenho não se torna fato porque o modelo escreveu uma seção bonita. Alguns pontos precisam de documentação oficial. Outros, de contrato. Outros, de um teste no ambiente real.
Plan mode ajuda; eu ainda prefiro perguntas e respostas em bullets
O Plan mode melhora a UX dessa conversa. Ele inspeciona contexto, organiza perguntas e cria pausas claras antes da implementação. Essa ideia aparece no Codex, no Plan mode do Claude Code e nos implementation plans revisáveis do Google Antigravity. As interfaces mudam; o ponto útil é poder analisar e corrigir o plano antes do código.
Mesmo assim, para especificações longas, tenho preferido um formato bem menos sofisticado: perguntas numeradas e respostas em bullets.
Consigo ler vinte perguntas de uma vez, responder em blocos, anotar exceções e deixar recomende onde ainda não tenho uma opinião fechada. O resultado também fica fácil de preservar como artefato e comparar com a spec atualizada.
Os dois formatos resolvem o mesmo problema. Plan mode organiza melhor a interação; bullets me dão mais velocidade quando há muitas decisões conectadas.
Pedi 100 perguntas. O agent entregou as 100, rsrs
Em outra especificação, a do Agent Kavor, pedi que o agent lesse as specs e ADRs existentes e retornasse todas as 100 perguntas abertas sobre análise, design e requisitos. A instrução principal era não perguntar o óbvio nem repetir o que já estava decidido.
Ele entregou as 100. Numeradas.
Eu respondi em blocos e usei o resultado para fechar decisões que estavam espalhadas entre documentos diferentes. Portanto, sim: se você pedir 100 dúvidas, ele provavelmente vai encontrar 100 dúvidas, rsrs.
Mas 100 não é um número ideal. Pode ser só uma ótima forma de gastar tokens e fabricar ansiedade. O valor veio de quatro limites:
- ler os artefatos existentes antes de perguntar;
- eliminar perguntas óbvias e decisões já fechadas;
- focar em lacunas que mudavam o design ou a implementação;
- devolver cada resposta para specs duráveis, em vez de abandoná-la no chat.
Doze perguntas consequentes vencem cem perguntas genéricas. As cem fizeram sentido naquele caso porque havia muitos documentos, relações e decisões incompletas.
O loop útil não termina na resposta
A entrevista só gera valor quando a decisão volta para o projeto. Meu loop tem ficado assim:
pergunta → resposta → contradição → decisão alterada → spec atualizadaDepois repito a análise sobre a nova versão. A pergunta deixa de ser “há mais alguma coisa?” e passa a ser “qual incerteza restante ainda pode mudar a arquitetura, quebrar a integração ou impedir a operação?”.
Não considero isso prova de que existe um processo universal. Mas a convergência está documentada: o GitHub Spec Kit organiza especificação, plano, tarefas e implementação; o Kiro Specs mantém requisitos, design e tarefas como artefatos revisáveis; o Claude Code tem um modo de planejamento que pesquisa e propõe sem editar; e o Google Antigravity produz planos e outros artifacts para revisão. Quando gerar código fica barato, preservar intenção, decisões e critérios de aceitação fica ainda mais valioso.
A pesquisa em engenharia de requisitos segue uma direção parecida. Um trabalho sobre IA generativa em requirements engineering discute uso em elicitação, análise, especificação e validação. Uma pesquisa com 55 profissionais encontrou colaboração entre humanos e IA com muito mais frequência do que automação integral. É uma amostra pequena, não um retrato definitivo da indústria, mas a direção combina com o que tenho observado: o ganho vem da parceria crítica, não da terceirização da decisão.
O risco é criar um belo teatro de análise
Há um contraponto forte. Uma entrevista longa pode produzir centenas de perguntas, vários documentos e uma sensação enorme de rigor sem reduzir um único risco real.
Agents inventam edge cases, repetem a mesma dúvida com palavras diferentes e sugerem a arquitetura da moda. Se o contexto estiver errado, um modelo mais capaz apenas argumenta melhor a favor da premissa errada.
Por isso, eu corto o processo quando:
- a dúvida já foi respondida por código, contrato ou documentação;
- a decisão é pequena, reversível e mais barata de testar;
- o agent está ampliando escopo sem mudar o resultado;
- uma integração precisa de evidência, não de mais prosa;
- uma abstração existe apenas para acomodar futuros imaginários.
Especificação não é competição de quantidade. O objetivo é reduzir decisões acidentais durante a implementação e deixar visível aquilo que ainda não sabemos.
Meu “10x” acontece antes do código
Quando uso o melhor modelo que tenho disponível com o thinking level mais alto, sinto que multiplico por dez minha capacidade de abstrair e analisar. É uma percepção pessoal, não um benchmark.
O ganho vem da quantidade de hipóteses que consigo explorar, contestar e comparar sem precisar segurar tudo na memória. Uma rodada encontra falhas. Outra cruza a decisão com a arquitetura existente. Outra tenta desmontar a própria recomendação. Isso reduz erros evitáveis no meu desenvolvimento porque várias escolhas ruins morrem ainda na spec.
Esse modo custa mais tempo e tokens. O Codex oferece níveis de esforço até xhigh; o Claude Code permite ajustar o effort em modelos compatíveis; e o Google Antigravity expõe variantes de modelos com diferentes níveis de raciocínio. Isso não promete “10x” nem acerto automático. A revisão humana continua fazendo parte do trabalho.
É aí que a engenharia de software continua soberana. O modelo ajuda a enumerar cenários; eu respondo pelo contexto. Ele compara alternativas; eu respondo pelo trade-off. Ele aponta que algo pode falhar; contrato, teste e produção dizem se aquela hipótese é real.
Quanto mais convincente o agent fica, mais importante é saber contestá-lo.
É uma das ideias por trás do Agent Kavor
Quero levar esse fluxo para além de uma conversa linear. Essa é uma das ideias por trás do agentkavor.com, que vem aí: trabalhar a spec visualmente, ligar artefatos e agents num grafo e deixar o Agent Kavor coordenar implementação, saídas e rastreabilidade.
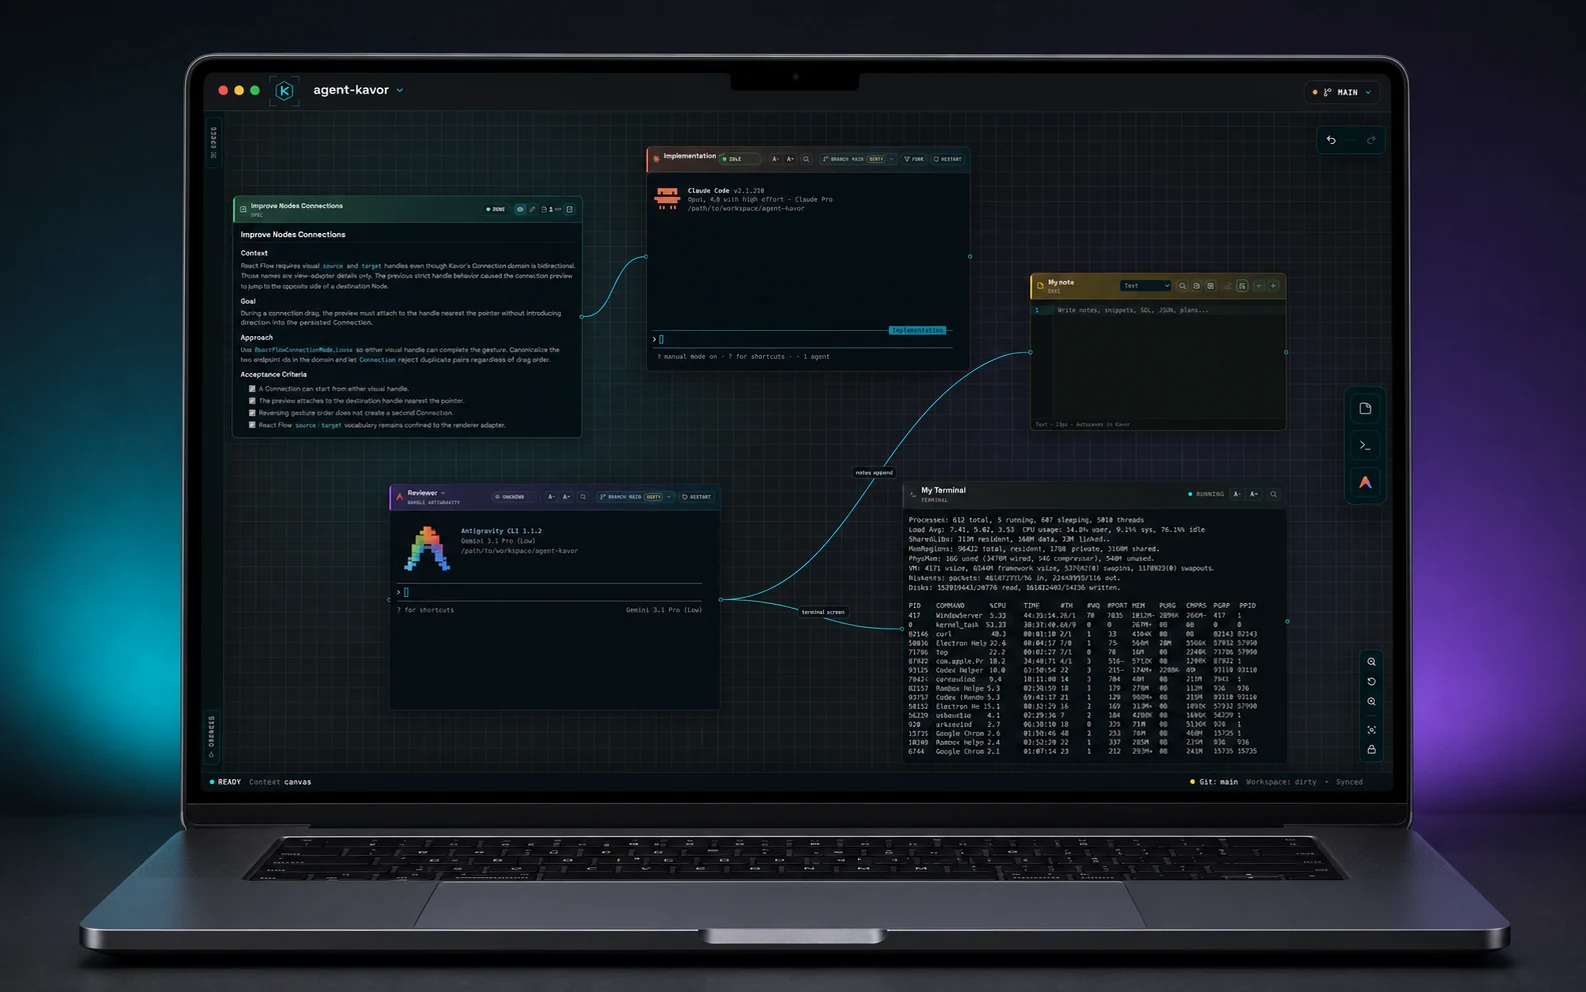
Um gostinho do Agent Kavor: specs, agents e outputs ligados no mesmo canvas.
A parte que quero preservar é simples: o usuário mantém o foco nas decisões da spec; os agents executam o loop ao redor dela. Porque terminar uma longa especificação mudando o requisito não é retrabalho. Retrabalho seria descobrir o mesmo erro depois de implementar tudo.
O que este artigo provocou?
Você pode marcar mais de uma opção e desfazer quando quiser.
Comentários
Carregando comentários…