
IA et Agents · Architecture logicielle
J’ai passé des heures à spécifier une fonctionnalité avec des agents — et j’ai changé le besoin de départ
J’ai passé plusieurs heures à spécifier une fonctionnalité avec des agents. À la fin, je n’avais toujours pas écrit la première ligne de code. Mieux : je ne voulais plus implémenter exactement ce que j’avais demandé au départ.
La fonctionnalité semblait pourtant simple. Il s’agissait d’un composant local, multiplateforme, chargé de coordonner des applications externes sans exposer cette complexité à l’utilisateur. C’était le genre de sujet qu’on résume facilement en deux phrases avant de partir coder.
J’ai fait l’inverse. J’ai commencé par cette demande :
Interroge-moi pour préciser cette fonctionnalité avant d’écrire du code. Couvre les exigences fonctionnelles et non fonctionnelles, l’architecture, les intégrations, la stack, la sécurité, l’exploitation, les pannes, les tests et le déploiement. Ne demande pas ce qui est déjà clair. Sépare les décisions, les recommandations, les vraies questions et les points qui exigent une preuve.
« Interroge-moi pour préciser » est probablement ce qui se rapproche le plus d’un prompt magique dans mon travail actuel. Pas parce que la formule produit une bonne spécification toute seule. Elle change surtout le rôle de l’agent : au lieu de courir vers l’implémentation, il doit chercher ce qui manque, ce qui se contredit et ce qui pourrait casser plus tard.
Dans ce cas précis, l’interview a changé quatre décisions importantes avant que le code existe.
Le composant « simple » ne l’était pas vraiment
Les premières questions ont vite débordé du comportement visible. Il fallait aussi parler des applications externes, de la sécurité, de volumes importants, de concurrence, des systèmes d’exploitation pris en charge, de l’installation, des mises à jour, de la reprise après panne, de l’observabilité et du cycle de vie du processus.
Ce n’est pas une découverte très spectaculaire : un logiciel de production a des contraintes de production. Le gain vient du moment où elles apparaissent. Les trouver dans une interview coûte quelques réponses. Les trouver après une première version coûte du code à jeter, une migration ou un incident.
Voici ce qui a bougé pendant cette spécification :
| Hypothèse de départ | Ce que l’interview a forcé à examiner | Décision après analyse |
|---|---|---|
| « Le composant est simple » | Intégrations, charge, cycle de vie, mises à jour et récupération | Le traiter comme un système de production avec des limites explicites |
| La première stack proposée conviendra | Identifier la contrainte technique dominante | Refaire la comparaison et changer la recommandation |
| Davantage de modules rendront le système plus sûr | Distinguer les limites réelles des abstractions spéculatives | Garder une fondation plus petite |
| Le processus peut s’arrêter après une période d’inactivité | Prendre en compte du travail externe qui arrive plus tard | Lier son cycle de vie aux processus réels et au travail actif |
| Une longue spec signifie que tout est prêt | Séparer les décisions des inconnues qui exigent des preuves | Implémenter la fondation et tester les risques restants |
L’agent n’a pas eu toutes ces bonnes idées tout seul. J’ai contesté sa première recommandation de stack. Quand la forte concurrence est devenue une contrainte dominante, nous avons repris la comparaison avec ce critère au centre. La conclusion a changé.
J’ai aussi arrêté une proposition d’architecture qui commençait à multiplier les modules. Elle paraissait propre sur le papier, mais plusieurs frontières n’avaient pas encore de raison concrète d’exister. Nous avons simplifié la base avant de payer le prix de ces abstractions.
Puis une règle de cycle de vie, raisonnable au premier regard, s’est révélée dangereuse. Arrêter le composant après un délai d’inactivité pouvait interrompre du travail lancé plus tard par une application externe. La règle a été corrigée : le processus devait suivre l’activité et les processus réellement en cours, avec un comportement conservateur quand ce suivi n’était pas fiable.
C’est exactement le résultat que je cherche. La spec n’est pas devenue plus belle. Le besoin est devenu moins faux.
Je mène l’interview par zones de risque
Une demande comme « quelles sont tes questions ? » fonctionne, mais elle produit souvent les premières questions auxquelles tout le monde pense. Je préfère orienter l’agent par zones, sans lui dicter les réponses :
- le résultat attendu, les acteurs, les parcours et les critères d’acceptation ;
- les comportements, les états, les transitions et les cas d’échec ;
- les performances, le volume, la latence, la disponibilité et la récupération ;
- la sécurité, les secrets, les autorisations, les données et les frontières de confiance ;
- l’architecture existante et les contraintes que la fonctionnalité ne peut pas déplacer ;
- les intégrations externes, leurs contrats, leurs versions et leur comportement en cas de panne ;
- les options de stack et la contrainte qui doit réellement guider le choix ;
- l’installation, la migration, le déploiement, la mise à jour, le retour arrière et le support ;
- la stratégie de test et les inconnues qui demandent un spike plutôt qu’une opinion.
Ensuite, je réponds vite. Une ligne suffit souvent : oui, non, une décision courte ou recommande quand je veux que l’agent propose une option. Il met à jour la spec, signale les contradictions et prépare le tour suivant.
Le tour le plus important est souvent le dernier : « Pose-moi seulement les questions qui peuvent encore modifier l’analyse, le design ou l’implémentation. » Puis je demande : « Qu’est-ce qui est implémentable maintenant, et qu’est-ce qui dépend encore d’une preuve ? »
Dans mon cas, le contrôle final n’a pas déclaré que tout était prêt parce que le document était long. Il a identifié une fondation implémentable et trois questions d’intégration ou de performance qui exigeaient encore des contrats, des spikes ou des essais dans l’environnement réel. C’est une réponse beaucoup plus utile qu’un grand feu vert en Markdown.
Plan mode est agréable ; les listes sont plus rapides pour moi
Le Plan mode améliore l’expérience quand l’agent doit inspecter le contexte et attendre une décision. Codex, le Plan mode de Claude Code et les plans révisables de Google Antigravity permettent tous de corriger le plan avant le code.
Je l’ai utilisé pour reformuler une première série en 12 questions structurées. L’interface était claire. Malgré cela, je préfère aujourd’hui une liste ordinaire de questions et de réponses. Je peux la parcourir plus vite, répondre à plusieurs points en bloc, annoter une nuance et conserver l’ensemble comme artefact.
Les deux formats servent la même méthode. Plan mode organise l’interaction. La liste me donne davantage de débit. Ce qui compte n’est pas le composant d’interface, mais la boucle :
question → réponse → contradiction → décision → spec mise à jourUne interview qui ne remet pas ses décisions dans un document durable devient simplement une longue conversation impossible à relire.
Oui, l’agent a produit les 100 questions
J’ai poussé l’idée assez loin sur Agent Kavor. J’avais plusieurs specs et ADRs dont les décisions étaient dispersées. J’ai demandé à l’agent de lire les artefacts, d’écarter tout ce qui était évident ou déjà décidé, puis de me rendre les 100 questions encore ouvertes sur l’analyse, le design et l’implémentation.
Il ne m’a pas demandé si j’étais sérieux. Il a produit une liste numérotée de 1 à 100.
J’ai répondu par blocs et les décisions ont été réintégrées dans les specs. L’exercice a été utile, mais le nombre 100 n’a rien de vertueux. Douze bonnes questions peuvent valoir mieux que cent questions décoratives.
Les contraintes données à l’agent ont fait la différence : lire les documents avant de demander, ignorer ce qui était clos, concentrer les questions sur ce qui pouvait changer le design, puis matérialiser les réponses. Sans cela, demander cent questions est surtout une excellente façon d’obtenir cent questions.
Le meilleur modèle ne remplace pas le meilleur jugement
Pour cette phase, j’utilise le modèle le plus capable auquel j’ai accès avec un niveau de raisonnement élevé. Codex propose un effort jusqu’à xhigh, Claude Code permet de régler l’effort des modèles compatibles et Google Antigravity expose des variantes avec différents niveaux de raisonnement. Cela prend davantage de temps et de tokens.
Dans mon expérience, l’effet ressemble à un gain de capacité d’analyse de 10x. Ce n’est ni un benchmark ni une promesse. Je peux simplement examiner beaucoup plus d’hypothèses, de contraintes et de contre-exemples que je ne le ferais seul dans le même temps. Et quand une mauvaise décision est corrigée avant de devenir du code, j’évite une classe d’erreurs de développement tout à fait prévisible.
La limite est importante : un agent peut raisonner longtemps sur une hypothèse fausse. Il peut citer une intégration qui n’existe pas, surévaluer un cas limite ou recommander la stack qu’il connaît le mieux. Un raisonnement plus long peut aussi produire une erreur plus convaincante.
L’ingénierie logicielle reste donc souveraine. C’est l’ingénieur qui fournit le contexte, reconnaît une contrainte métier, conteste une architecture, demande une preuve et assume l’arbitrage. L’agent multiplie les angles d’analyse ; il ne reçoit pas la responsabilité avec le prompt.
Le vrai risque : le théâtre d’analyse
On peut transformer cette méthode en processus très sophistiqué et très inutile. Il suffit de mesurer la qualité au nombre de questions, à la taille de la spec ou au volume de tokens consommés.
Un agent est parfaitement capable d’inventer des scénarios improbables, de reformuler trois fois la même incertitude et de proposer une architecture complète pour un problème encore mal compris. La documentation augmente alors, mais la connaissance non.
J’utilise quelques freins simples :
- donner le contexte du dépôt, les contraintes métier et les non-objectifs ;
- demander les questions qui changent une décision, pas toutes les questions possibles ;
- séparer les faits, les recommandations, les hypothèses et les inconnues ;
- exiger une source, un contrat ou un spike pour les intégrations incertaines ;
- contester les abstractions qui n’ont pas encore de frontière réelle ;
- arrêter l’interview quand une expérience ciblée coûte moins cher qu’un nouveau tour.
Ce dernier point évite de confondre prudence et paralysie. Une bonne spec n’élimine pas l’itération. Elle indique simplement où l’on sait, où l’on choisit et où l’on doit encore apprendre.
Ce mouvement existe déjà au-delà de mon workflow
Cela ne prouve pas qu’un processus universel existe, mais la convergence est documentée. GitHub Spec Kit place la spécification avant le plan, les tâches et l’implémentation ; Kiro Specs conserve les exigences et le design comme artefacts révisables ; Claude Code peut explorer et proposer sans modifier ; et Google Antigravity produit des plans et d’autres artifacts à relire.
La recherche en ingénierie des exigences explore aussi les LLM pour l’élicitation, l’analyse, la spécification et la validation. Un article consacré à ces usages présente à la fois les possibilités et les limites. Une petite enquête menée auprès de 55 professionnels, acceptée dans un workshop d’ASE 2025, décrit la collaboration humain–IA comme le mode dominant parmi ses répondants, loin devant l’automatisation complète. Ce n’est pas une mesure de toute l’industrie, mais la direction correspond à ce que j’observe dans mon propre travail.
Une revue systématique de la littérature garde le nécessaire contrepoids : reproductibilité, contrôle, validation et maturité des travaux restent des problèmes ouverts. Autrement dit, les outils commencent à formaliser la pratique, mais personne n’a aboli le besoin de vérifier.
Agent Kavor vient précisément de cette boucle
C’est aussi une des idées derrière agentkavor.com, qui arrive. Je veux sortir cette boucle de la conversation linéaire : l’utilisateur travaille la spec visuellement, relie les artefacts et les agents dans un graphe, puis Agent Kavor orchestre l’implémentation, les sorties et la traçabilité.
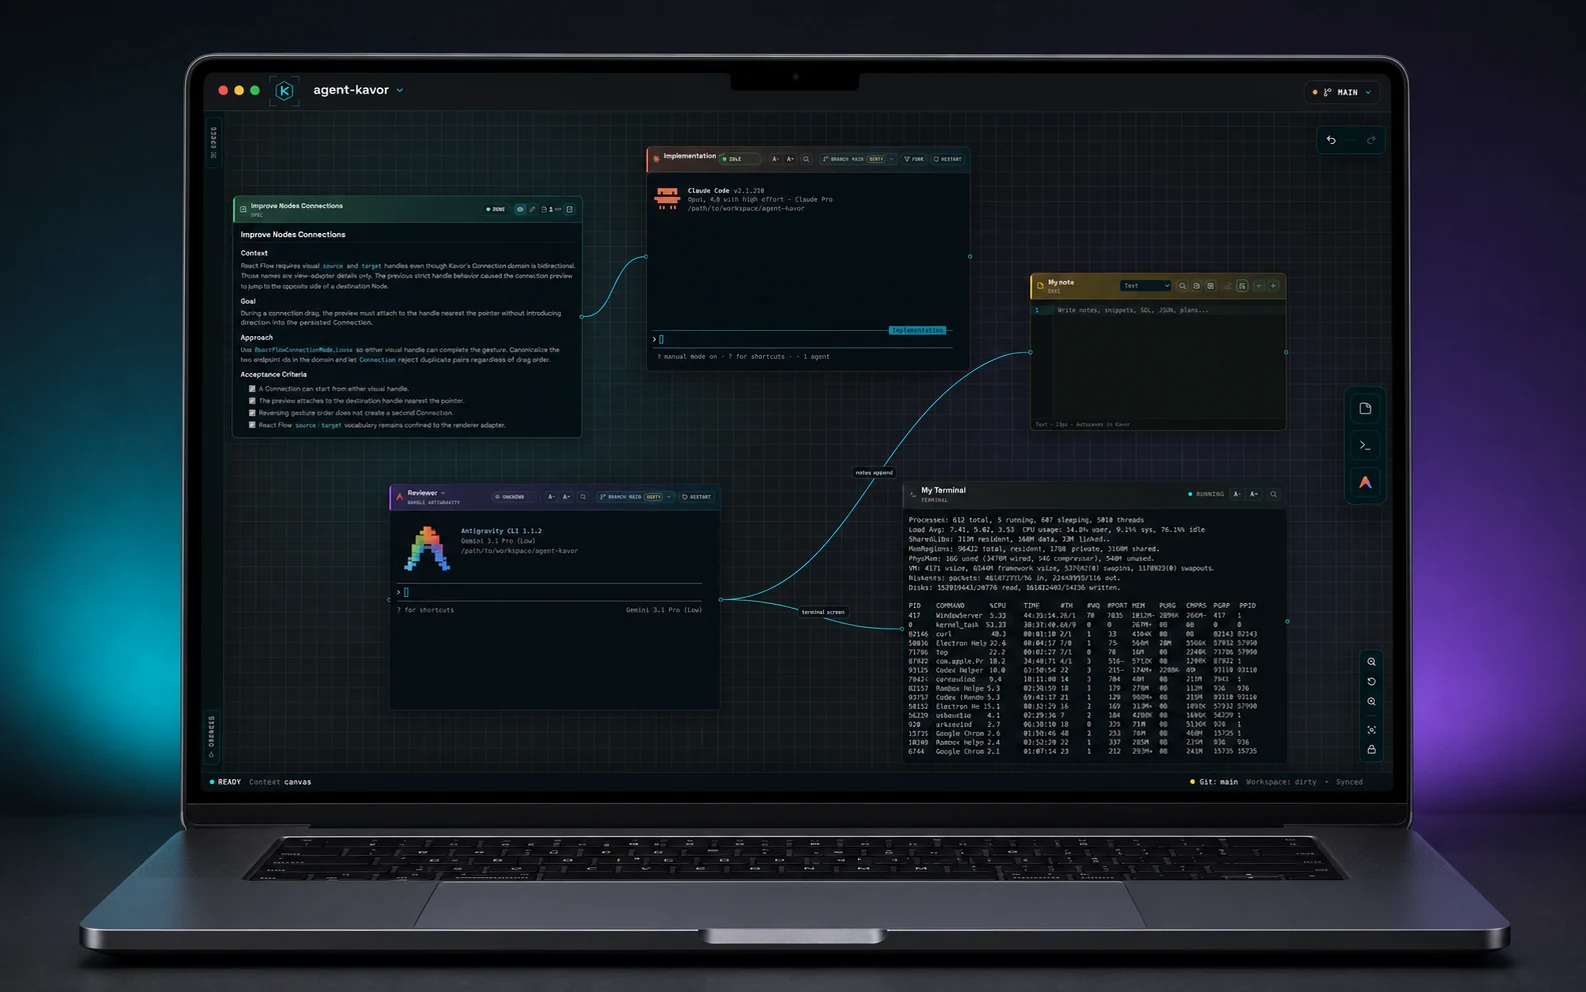
Un aperçu d’Agent Kavor : specs, agents et outputs reliés sur le même canvas.
Pour l’instant, le meilleur outil tient déjà en une phrase : « Interroge-moi avant de coder. » À condition de garder le droit de répondre à l’agent qu’il pose la mauvaise question.
Qu’est-ce que cet article a suscité ?
Choisissez plusieurs options et annulez-les à tout moment.
Commentaires
Chargement des commentaires…