
IA et Agents · Ingénierie logicielle
La prochaine génération de l’ingénierie logicielle ne se fera pas dans un chat
Le FIXER devait corriger trois bugs. Le TESTER, lui, préparait une refonte de la structure des tests et de nouveaux scénarios de régression. Les deux pouvaient modifier des zones voisines. Je ne voulais ni créer un worktree séparé, ni laisser deux agents réinventer chacun la moitié du même dispositif.
J’ai donc demandé au TESTER de prévenir le FIXER. Le message était simple : avance sur les corrections fonctionnelles, mais attends que la nouvelle structure soit prête avant d’ajouter les tests. Le FIXER a suspendu cette partie, reçu le handoff, gardé les scénarios en attente et annoncé les fichiers qu’il avait touchés pour éviter qu’ils soient écrasés. Pendant ce temps, le TESTER a limité son périmètre aux tests, à la configuration, à HTTP et à SQLite, tandis qu’un autre agent conservait la responsabilité de DCMTK.
Ce qui m’intéresse ici n’est pas le petit frisson de voir deux agents se parler. La démonstration amusante dure dix secondes. Le vrai travail commence juste après : qui possède quoi, quelle décision doit survivre à la conversation, quel état est fiable, quelle preuve autorise l’étape suivante et qui a le droit de dire « on livre ».
Cette scène a cristallisé une conviction que mes autres sessions rendaient déjà difficile à ignorer : l’IA a rendu la production de code abondante. Elle n’a pas rendu l’ingénierie abondante. Au contraire, quand l’implémentation accélère, l’intention durable, les frontières de responsabilité, la revue, les preuves et les décisions de release deviennent plus rares — donc plus précieuses.
Le chat reste un excellent outil. Mais c’est une mauvaise abstraction principale pour un système d’ingénierie logicielle.
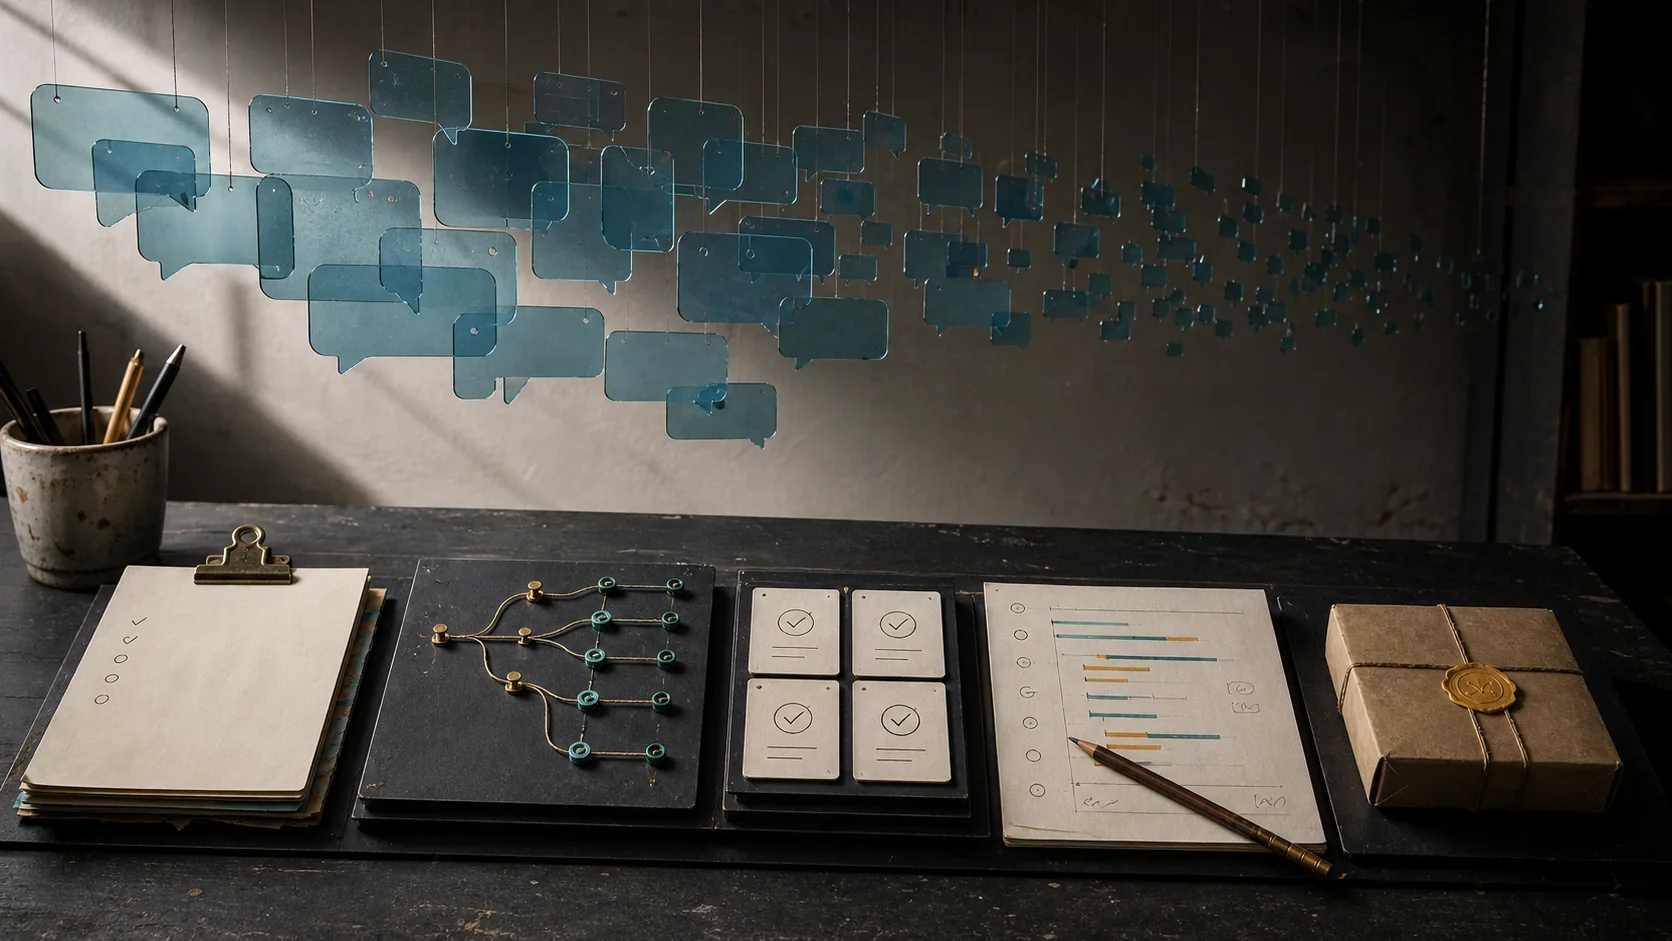
La conversation passe. Les artefacts qui portent le travail restent.
1. Le handoff vaut plus que la conversation
On pourrait raconter l’épisode TESTER/FIXER comme une conversation réussie : un agent envoie un message, l’autre comprend, tout le monde est content. Ce serait exact et presque sans intérêt.
Ce qui a rendu la coordination utile, c’est la frontière qu’elle transportait. Le TESTER possédait la structure externe des tests et les scénarios de régression. Le FIXER possédait les corrections fonctionnelles. La consigne n’était pas « collaborez bien ». Elle disait où attendre, ce qui pouvait avancer, ce qui devait rester en suspens et comment signaler les fichiers modifiés.
Le détail compte. Le FIXER n’a pas créé son propre agencement de tests pour gagner quelques minutes. Il a accepté une dépendance explicite. Le TESTER, de son côté, n’a pas élargi son domaine sous prétexte qu’il était déjà dans le dépôt. Il a annoncé qu’il ne toucherait ni au runtime DCMTK ni à son CI pendant que cet espace appartenait à un autre agent.
Une conversation peut contenir cette décision. Un système d’ingénierie doit pouvoir la représenter.
Cela suppose au minimum un propriétaire, un périmètre, un état d’attente, un événement de reprise et une trace consultable. Sans cela, le « handoff » est seulement un paragraphe perdu au milieu de deux historiques. Tout fonctionne tant que chacun se rappelle la bonne phrase, que la compaction la conserve et que personne ne change de session au mauvais moment. C’est une fondation étonnamment fragile pour du code que l’on compte maintenir.
La coordination ne devient pas sérieuse parce que les agents parlent entre eux. Elle le devient lorsque leur échange modifie un état explicite du travail.
2. Le code a changé de prix, pas les décisions
Pendant longtemps, écrire le code était le goulot visible. Une idée passait par des semaines d’implémentation, et cette lenteur absorbait une bonne partie du risque : il fallait choisir ce qui méritait l’effort avant que l’effort commence.
Les agents déplacent ce rapport. Ils peuvent explorer un dépôt, modifier plusieurs fichiers, lancer des outils, corriger des erreurs et répéter la boucle à une vitesse qui rend des changements autrefois coûteux presque banals. C’est formidable. C’est aussi une machine à amplifier une décision médiocre.
Si la frontière métier est fausse, produire cinq fois plus de code ne donne pas cinq fois plus de logiciel. Cela donne davantage de surface à défaire. Si la source de vérité est ambiguë, accélérer l’implémentation accélère la divergence. Si les tests valident le mauvais contrat, un écran rempli de vert ne répare rien. Si personne ne porte la responsabilité de la release, générer un package plus vite ne répond toujours pas à la question : faut-il le promouvoir ?
Voilà l’inversion : le code devient abondant, tandis que l’ingénierie cohérente reste rare.
Par ingénierie, je n’entends pas une couche de cérémonies posée au-dessus du développement. J’entends des actes très concrets : faire émerger une contradiction avant de coder ; conserver une décision dans une spécification ; isoler deux modifications susceptibles de se chevaucher ; demander une revue indépendante après des tests verts ; refuser de déformer une API de production pour rendre un test plus commode ; arrêter une release quand un bug critique apparaît.
Ces actes ne sont pas le « travail autour du code ». Ils déterminent quel code mérite d’exister, sous quelle forme, avec quelles preuves et sous quelle autorité.
Les agents peuvent accomplir une grande partie de ce travail. Ce qui ne suit pas automatiquement, c’est le système qui relie les actes entre eux. Un chat les présente comme une suite de messages. Un projet doit les traiter comme une suite de décisions et d’états durables.
3. Le chat est excellent — dans son domaine
Critiquer le chat comme abstraction ne revient pas à prétendre qu’il ne sert à rien. Ce serait contredit par mon propre travail.
Pour une tâche locale et cohérente, le chat est difficile à battre. Je peux exposer un problème, laisser l’agent inspecter les fichiers, répondre à une question, corriger une interprétation et regarder les outils tourner. Le format est souple. Il supporte l’ambiguïté du départ, les bifurcations et les petites négociations qui seraient pénibles dans un formulaire rigide.
Les sessions modernes ne sont d’ailleurs plus de simples boîtes à prompts. Elles lisent des dépôts, exécutent des commandes, conservent un historique, utilisent des sous-agents et reprennent des travaux longs. La documentation d’Anthropic décrit explicitement des sessions qui incluent la conversation, les appels d’outils, leurs résultats et les fichiers lus dans la fenêtre de contexte, ainsi que des sous-agents dotés d’un contexte neuf qui renvoient une synthèse (Anthropic, gestion des sessions Claude Code).
Quand une seule responsabilité domine, cette continuité est une qualité. Une correction circonscrite, une exploration d’API ou un refactoring dont le contrat est clair n’a pas besoin d’une tour de contrôle. Ajouter un orchestrateur, des files d’attente, cinq statuts et trois approbations à chaque renommage de variable serait une manière très moderne de recréer le comité de pilotage dans le terminal.
Le problème apparaît quand le chat cesse d’être une interface locale et devient, sans qu’on le dise, la mémoire du projet, le moteur du workflow, le registre de décisions et la preuve de livraison. Ces fonctions ont des contraintes différentes. Les fondre dans une timeline agréable à lire masque la différence entre « cette phrase existe quelque part dans l’historique » et « cette décision gouverne encore le travail ».
Je veux donc garder le chat là où il est fort : l’exploration, l’explication, la correction rapide et l’exécution locale. Je refuse seulement de lui confier par défaut la continuité institutionnelle du logiciel.
4. Une timeline lisible n’est pas un état de projet
L’interface conversationnelle produit une illusion particulièrement séduisante : tout semble se suivre parce que tout apparaît dans le même fil.
Le premier message est encore visible. Les réponses s’empilent. Le dernier agent parle comme s’il se souvenait du début. Pour l’humain, la continuité visuelle suffit souvent à donner l’impression d’une continuité de compréhension.
Mais plusieurs choses peuvent avoir changé sous cette surface : des messages ont été compactés ; des sorties d’outils ont disparu du contexte actif ; un autre modèle a pris la requête suivante ; un sous-agent n’a reçu qu’une synthèse ; une instruction importante vit uniquement dans la conversation ; le dépôt a avancé pendant que le fil restait immobile.
Un état de projet répond à des questions plus dures que « que nous sommes-nous dit ? » :
- Quelle version de la spécification fait autorité ?
- Quels critères d’acceptation restent ouverts ?
- Quel diff a été revu, et contre quel commit ?
- Quels tests ont réellement tourné ?
- Quel agent possède la prochaine modification ?
- Une soumission ambiguë peut-elle être répétée sans risque ?
- Qui a retenu, autorisé ou annulé la promotion ?
Le transcript peut aider à reconstruire les réponses. Il ne devrait pas être l’unique endroit où elles existent.
Cette distinction ressemble à celle que nous faisons déjà entre un log et une base transactionnelle. Le log raconte. La base porte les invariants. Bien sûr, certains systèmes événementiels font du log la source de vérité, mais ils y ajoutent alors des identités, de l’ordre, de l’idempotence, des schémas et des règles de relecture. Une conversation ordinaire n’acquiert pas ces propriétés simplement parce qu’elle est longue.
Le fil est une vue pratique du travail. Il n’est pas le travail lui-même.
5. Le contexte ressemble à de la mémoire de travail
Une fenêtre de contexte rassemble ce dont le modèle dispose pour produire la prochaine réponse. Selon l’outil, elle peut contenir des instructions, la conversation, des appels d’outils, leurs sorties et des fichiers lus. C’est énormément plus puissant qu’un prompt isolé. C’est aussi une ressource finie, réorganisée par le produit.
J’utilise volontiers l’analogie avec la RAM : le contexte est une mémoire de travail, pas une base de connaissances d’ingénierie. L’analogie a ses limites — je ne prétends pas que les mécanismes soient identiques — mais elle force la bonne question. Qu’arrive-t-il à une décision quand elle n’est plus chargée ?
Si la réponse est « elle se trouve peut-être dans un ancien message », nous avons un archivage, pas une source de vérité opérationnelle. Si la réponse est « le modèle devrait pouvoir la retrouver », nous avons une espérance, pas un invariant. Si la réponse est « elle a été résumée », il faut savoir quelle nuance a survécu.
Les artefacts durables changent la nature du problème. Une spécification versionnée peut être relue après un redémarrage. Un ADR porte le raisonnement et le statut d’une décision. Git relie un changement à son histoire. Un test encode un comportement exécutable. Un rapport de revue conserve un finding même si le reviewer disparaît. Un manifeste de release et une preuve de rollback ne dépendent pas de la mémoire du modèle qui a piloté l’opération.
Ils ne sont pas parfaits. Une spécification peut être obsolète, un test incomplet, un ADR mal écrit. Mais leurs défauts sont inspectables. On peut les comparer, les dater, les corriger et déterminer lequel fait autorité. Une mémoire conversationnelle, elle, peut échouer avec beaucoup plus de grâce : la réponse reste fluide alors que la prémisse importante n’est plus là.
Le point n’est donc pas de sortir tout le contexte du chat. Il est de sortir du chat ce qui doit survivre à un changement de contexte.
6. La compaction est un changement d’état
La compaction permet aux sessions longues de continuer. C’est une réponse nécessaire à une limite réelle. Mais l’expérience utilisateur la présente souvent comme une continuité alors qu’elle transforme ce qui sera disponible ensuite.
Anthropic décrit /compact comme le remplacement de l’historique par un résumé avec perte. Sa documentation précise aussi que d’anciennes sorties d’outils peuvent être supprimées avant la synthèse, tandis que des instructions stockées sur disque, comme celles d’un fichier de projet, peuvent être rechargées (glossaire Claude Code). OpenAI décrit un mécanisme différent : la compaction native de la Responses API peut produire un élément chiffré et économe en tokens, accompagné d’éléments antérieurs jugés importants, afin de poursuivre au-delà de la limite (OpenAI, compaction dans la Responses API). Codex peut lui aussi remplacer l’entrée par une liste représentative plus petite et utiliser un élément opaque de type compaction (OpenAI, boucle d’agent Codex).
Ces mécanismes ne sont pas équivalents. Je n’ai aucune base pour affirmer qu’ils perdent les mêmes informations, ni dans les mêmes proportions. L’un est explicitement présenté comme un résumé avec perte ; l’autre comme une représentation opaque destinée à préserver une compréhension latente. La distinction doit rester visible.
Ils partagent cependant une propriété d’architecture : après la transition, le prochain exécutant ne travaille plus avec exactement la même représentation de l’histoire.
Cela suffit à rendre dangereuse une décision qui n’existe que dans une phrase ancienne. La compaction peut parfaitement préserver « implémenter le nouveau flux Git » tout en comprimant la nuance « Git doit rester l’unique source de vérité, donc ne pas dupliquer cet état dans une autre couche ». Je ne dis pas que cet oubli se produira. Je dis qu’un système sérieux ne devrait pas dépendre du fait qu’il ne se produise jamais.
La compaction n’est pas une trahison du chat. C’est une optimisation utile. Le défaut consiste à la traiter comme si elle ne changeait rien au contrat de mémoire.
7. Le détail qui disparaît était peut-être le contrat
L’exemple le plus instructif vient de la documentation d’Anthropic elle-même. Dans un scénario de compaction automatique, une synthèse peut conserver le travail principal tout en omettant un avertissement dont l’importance pour la prochaine tâche n’était pas prévisible au moment de résumer (Anthropic, gestion des sessions).
Ce n’est pas un cas vécu dans mes projets, et je ne vais pas lui prêter une biographie. Il révèle simplement une contrainte fondamentale : un résumé doit estimer aujourd’hui ce qui sera important demain.
Or les décisions d’ingénierie changent souvent de rôle. Une remarque sur un format de migration devient critique quand une nouvelle plateforme entre dans le périmètre. Une limitation de cache, secondaire pendant le développement, devient centrale lors d’un rollback. Un « ne touchez pas à cette API » paraît anecdotique jusqu’à ce qu’un testeur cherche un raccourci. Un risque accepté dans une branche expérimentale n’est plus acceptable au moment de promouvoir un canal stable.
La valeur d’un artefact durable ne vient pas d’une mémoire infinie. Elle vient de son adressabilité. On peut pointer vers la décision, la relier au travail, vérifier sa version et savoir si elle est toujours active. Le système n’a pas besoin de deviner à chaque synthèse qu’elle sera importante.
C’est aussi pour cela qu’une bonne spécification ne doit pas être une transcription nettoyée du chat. Elle sélectionne explicitement les contrats, les critères d’acceptation, les risques, les décisions et les inconnues. Elle transforme une négociation en objet de travail.
Si tout est gardé, rien n’est vraiment gouverné. Si tout est résumé, la gouvernance dépend du résumé. L’ingénierie a besoin d’un troisième geste : décider ce qui devient durable.
8. Changer de modèle, c’est changer d’exécutant
Une conversation peut garder le même décor pendant que l’exécutant change.
Claude Code documente que chaque modèle possède son propre cache de prompt et qu’une commande /model fait lire la même conversation au modèle choisi lors de la requête suivante, sans bénéficier des mêmes cache hits (Anthropic, cache de prompt). Le transcript ne disparaît donc pas. Mais le modèle, ses compromis de calcul et son cache ne sont plus les mêmes.
Dans une de mes sessions, j’ai utilisé Claude avec un effort xhigh pour recevoir, depuis un agent Codex chargé de la spécification, une demande de seconde revue indépendante. Ce cas ne prouve pas que Claude revoit mieux ou que Codex spécifie mieux. Il montre quelque chose de plus utile : le provider, le modèle, l’effort et la responsabilité peuvent être choisis séparément.
Cette séparation devrait être visible dans le système. Une seconde revue n’est pas seulement « la prochaine réponse du fil ». Elle a un mandat, un intrant durable, une indépendance recherchée et un résultat attendu. Si je change d’exécutant, je veux savoir quel contexte lui a été remis, quelle version il a examinée et où ses findings ont été enregistrés.
Le même principe vaut à l’intérieur d’un provider. Un réglage de raisonnement plus élevé peut être justifié pour une décision d’architecture et inutile pour une opération mécanique. Les recommandations officielles d’OpenAI insistent d’ailleurs sur l’évaluation des modèles et des niveaux d’effort sur des workloads représentatifs, plutôt que sur l’hypothèse que le maximum gagne toujours (guide OpenAI sur le choix des modèles). Les recommandations d’un fournisseur restent des recommandations de fournisseur, pas un benchmark indépendant.
Le chat masque cette allocation derrière un sélecteur commode. L’ingénierie doit la traiter comme une décision d’exécution : quel travail, quel contexte, quel coût, quelle indépendance, quelle preuve.
9. Le meilleur argument pour davantage de contexte
Il existe un contre-argument solide : si la fenêtre devient assez grande, pourquoi découper ? Chargeons le dépôt, l’historique, les spécifications et les résultats. Laissons un agent garder le tout en tête. Nous éviterons les handoffs, les synthèses, la duplication d’état et l’orchestration qui casse.
Cet argument est particulièrement fort pour les tâches transversales. Une migration globale, une recherche d’invariant ou une revue architecturale bénéficient réellement d’une inspection large. Les contextes plus grands réduisent certaines frontières artificielles. La recherche continue aussi d’améliorer l’efficacité et la récupération à longue distance ; les affirmations de SubQ sur l’attention parcimonieuse et les longs contextes, par exemple, montrent au minimum que le sujet est actif, même si leur rapport est produit par l’entreprise et n’a pas été reproduit indépendamment dans notre dossier (rapport technique SubQ).
Je ne veux donc pas remplacer le dogme « tout dans un chat » par le dogme « jamais de grand contexte ». Ce serait la même paresse, avec un diagramme différent.
La limite est que capacité nominale ne signifie pas utilisation uniforme. L’étude Lost in the Middle, publiée en 2024, a observé sur ses modèles et ses tâches de question-réponse multi-documents et de récupération clé-valeur des performances sensibles à la position de l’information : souvent meilleures près du début ou de la fin, plus faibles au milieu (Liu et al., TACL 2024). Ces expériences précèdent les modèles de 2026 et ne mesurent aucun de mes dépôts. Elles n’autorisent pas une conclusion universelle. Elles suffisent seulement à réfuter l’idée naïve selon laquelle « présent dans la fenêtre » veut toujours dire « utilisé de manière fiable ».
Et même un contexte parfait ne remplace pas l’autorité. Il peut contenir la décision de rollback ; il ne dit pas qui peut l’ordonner. Il peut contenir deux branches en conflit ; il ne choisit pas leur propriétaire. Il peut lire un test vert ; il ne décide pas si la preuve couvre le risque de release.
Le contexte augmente la capacité de l’exécutant. Il ne définit pas le système de responsabilité.
10. Le projet doit se souvenir sans le modèle
Une connaissance d’ingénierie mérite ce nom lorsqu’elle reste récupérable après la fin de la session qui l’a produite.
Dans mes projets, cela prend plusieurs formes. Une spécification en fichier conserve le contrat et son historique Git. Un ADR explique pourquoi une décision existe, ce qu’elle remplace et quelles conséquences elle accepte. Les commits montrent les changements réels. Les tests rendent certains comportements exécutables. Les findings de revue enregistrent ce qui a été observé et avec quelle sévérité. Les artefacts de release, les gates et les preuves opérationnelles séparent « le package existe » de « il peut être promu ».
J’ai formalisé cette distinction dans un ADR : la spécification durable est la source de vérité du besoin, tandis que l’état d’exécution et les outputs sont d’autres objets. Cette séparation paraît administrative jusqu’au premier redémarrage, au premier conflit ou au premier audit. Ensuite, elle ressemble surtout à du bon sens.
Un autre ADR traite les messages entre agents comme des enregistrements immuables avec des états de livraison explicites, une reprise après redémarrage et un traitement particulier des soumissions ambiguës. Là encore, l’idée n’est pas de rendre la conversation solennelle. Elle est d’éviter qu’un terminal scrapé soit confondu avec une vérité de livraison.
On peut résumer le contraste ainsi :
| État conversationnel | État d’ingénierie durable |
|---|---|
| Messages et sorties actuellement chargés | Spécification et ADRs versionnés |
| Synthèse après compaction | Décisions adressables avec historique |
| Réponse d’un agent | Diff, tests et findings vérifiables |
| Impression d’avancement | Statut fondé sur un événement observable |
| « Ça semble prêt » | Gate, autorité de promotion et plan de rollback |
Le côté gauche reste indispensable. C’est là que le raisonnement se déploie. Le côté droit empêche ce raisonnement de s’évaporer ou de se transformer silencieusement en certitude.
Cette séparation change aussi la reprise après incident. Imaginons que la session s’arrête au milieu d’un merge. Avec le transcript seul, le prochain exécutant doit reconstruire l’intention, vérifier le dépôt, deviner si une commande a produit un effet et décider s’il peut la répéter. Avec des artefacts explicites, il part d’un commit connu, d’un état de worktree observable, d’une opération identifiée et d’une règle d’idempotence. La conversation reste utile pour comprendre le raisonnement ; elle n’est plus chargée de prouver l’état du monde.
Le même raisonnement vaut pour une demande envoyée à un autre agent. Entre « le message apparaît dans mon terminal » et « le destinataire l’a accepté », plusieurs états existent : préparé, soumis, livré, reconnu, refusé, résultat reçu, issue ambiguë. Les écraser dans un booléen sent prépare les doublons. Les déduire d’un texte affiché prépare les faux positifs. Un registre de livraison ne rend pas les agents plus intelligents ; il rend leurs échecs moins mystérieux.
Il faut enfin distinguer la pérennité de l’accumulation. Garder chaque sortie d’outil pour toujours ne crée pas une bonne mémoire de projet. Une sortie volumineuse peut rester attachée à une exécution sans occuper le cœur de la spécification. Un finding accepté peut devenir une décision ; un finding rejeté garde sa justification ; un log temporaire peut expirer après que sa preuve utile a été extraite. La mémoire durable a besoin de politique, pas seulement de stockage.
11. Nous savions déjà découper avant les agents
Les agents donnent un visage neuf à un vieux problème : comment séparer le travail sans séparer ce qui doit rester cohérent.
Dans son article fondateur sur la modularisation, David Parnas compare des découpages et défend des modules organisés autour de décisions de conception susceptibles de changer, cachées derrière des interfaces (Parnas, On the Criteria To Be Used in Decomposing Systems into Modules). Il n’écrivait évidemment pas sur les LLM. J’en tire une analogie, pas une filiation historique : une bonne frontière d’agent devrait elle aussi protéger une responsabilité et ses décisions, au lieu de découper arbitrairement une liste de fichiers.
Le Domain-Driven Design apporte une autre idée utile. Un bounded context délimite l’endroit où un modèle particulier s’applique ; une context map rend explicites les relations entre ces espaces (référence DDD d’Eric Evans). Cela ne signifie pas « un agent par bounded context », encore moins « un microservice par agent ». Cela rappelle seulement qu’un mot comme Specification, Release ou Done peut avoir des règles distinctes selon le contexte, et que les passages entre ces règles méritent un contrat.
La mauvaise décomposition multi-agent ressemble à la mauvaise modularisation classique. On crée un agent backend, un agent frontend, un agent tests et un agent review parce que les étiquettes sont disponibles. Puis chacun doit comprendre la même décision cachée, et tous modifient le même état. Le nombre d’agents augmente ; l’indépendance, non.
La bonne question n’est pas « combien d’agents puis-je lancer ? ». C’est « quelles décisions peuvent évoluer indépendamment, quelles preuves doivent être produites, et où une seconde lecture apporte-t-elle une vraie valeur ? »
Parfois, la réponse tient dans une seule session. Une responsabilité cohérente, peu de risque de conflit et une validation locale ne justifient aucune séparation. Parfois, le test doit attendre la structure possédée par un autre agent. Parfois, la review doit arriver avec un contexte neuf précisément parce que l’implémenteur connaît trop bien ses propres intentions.
Les frontières ne sont pas une célébration de la multiplicité. Elles sont un moyen de contenir le changement et de rendre les responsabilités lisibles.
12. La spécification n’est pas le préambule du code
Dans une refonte récente, le point de départ semblait lexical : remplacer le concept de Task par celui de Specification. Une simple opération de renommage aurait été rapide. Elle aurait aussi conservé un modèle devenu trop pauvre.
La discussion a forcé plusieurs décisions explicites. Le contrat pouvait changer. La migration pouvait viser une base fraîche plutôt que simuler une compatibilité inexistante. La nouvelle spécification devait porter des critères d’acceptation, des états plus précis, des preuves, des outputs et de la traçabilité. Son comportement dans le backlog et sur le canvas devait évoluer. Sa relation avec les coding agents devenait plus forte. J’ai aussi demandé des revues de code par étapes.
Ce n’était plus un rename. C’était un changement de concept.
Le résultat intéressant n’est pas que l’agent ait produit un document plus long. C’est que les décisions aient quitté le statut de répliques dans une conversation pour entrer dans une spécification versionnée. Le fichier pouvait être comparé, revu et relié aux étapes d’implémentation. L’intention devenait indépendante de la session qui l’avait aidée à émerger.
Une spécification utile joue trois rôles.
D’abord, elle délimite. Elle dit ce qui change, ce qui ne change pas et quelle compatibilité est réellement exigée. Ensuite, elle rend les contradictions visibles : un état done sans preuve, une suppression de table présentée comme une migration sans perte, une relation forte avec les agents sans état de livraison. Enfin, elle prépare la vérification : critères d’acceptation, outputs, traçabilité et gates de revue ne sont pas une annexe ; ils décrivent comment le système saura qu’il a obtenu le résultat voulu.
Cela ne rend pas la spec sacrée. Dans la session, j’ai même précisé qu’elle pourrait être supprimée à la fin. Un artefact durable peut avoir une durée de vie. Ce qui importe, c’est que sa disparition soit une décision, pas l’effet secondaire d’une compaction.
Le chat aide à découvrir la spécification. Le fichier permet au projet de l’utiliser.
Dans cet exemple, la transformation de Task en Specification touchait plusieurs invariants à la fois. Remplacer definitionOfDone par des critères d’acceptation ne consistait pas à renommer une propriété : les critères devaient pouvoir guider la vérification. Ajouter evidence, outputs et traceability obligeait à distinguer la déclaration « fini » des éléments qui la soutiennent. Les états draft, ready, in_progress, verifying, done et blocked ne valaient que si leurs transitions avaient un sens observable. Sans ces contrats, la nouvelle terminologie aurait simplement offert davantage de mots pour le même flou.
Le choix d’une base fraîche mérite aussi d’être dit clairement. « Pas de migration » peut masquer deux réalités opposées : aucune donnée existante n’est touchée, ou toutes les données existantes sont abandonnées. Ici, l’acceptation explicite de perdre l’ancienne table et l’ancien type de nœud permettait un changement de contrat sans prétendre conserver ce qui ne devait pas l’être. L’agent pouvait alors implémenter la bonne stratégie au lieu de fabriquer une compatibilité imaginaire par prudence.
Les revues par étapes complétaient le dispositif. Une revue avant que tout soit terminé peut encore modifier une frontière à faible coût. Une revue uniquement finale découvre parfois un mauvais modèle après que l’UI, le runtime, les tests et la persistance se sont déjà alignés dessus. Cela ne signifie pas qu’il faut interrompre chaque commit pour convoquer un reviewer. Cela signifie que la spec peut nommer les moments où une décision devient coûteuse à inverser.
13. Implémenter vite ne dispense pas de choisir une source de vérité
L’épisode suivant concernait le cycle Git des coding agents dans des worktrees. L’implémentation avait ajouté des métadonnées de branche, des opérations de rebase et de finish, la validation de propreté, le merge de retour, le nettoyage du worktree et la gestion explicite des conflits.
Les contrôles étaient verts : build, vérification de types, lint et 94 tests répartis sur dix fichiers selon le rapport de session. Un commit du dépôt, 3823ed6, conserve aussi une trace durable de cette amélioration du support des worktrees.
À ce stade, il aurait été facile de déclarer le travail terminé. J’ai demandé une revue.
La revue a relevé deux problèmes moyens et deux problèmes faibles. La séquence qui a suivi est plus importante que les nombres : l’analyse a montré un risque de duplication d’état, et j’ai choisi Git comme source de vérité. Une simplification supplémentaire et une nouvelle revue ont ensuite été autorisées.
Les tests n’avaient pas échoué. Ils vérifiaient les comportements que nous leur avions donnés. La review a posé une autre question : le modèle d’état était-il le bon ?
C’est une distinction classique, mais les agents la rendent urgente. Un implémenteur rapide peut matérialiser une architecture incohérente avec une excellente couverture de son incohérence. Les vérifications automatiques répondent à « cette implémentation satisfait-elle ces contraintes ? ». La revue peut encore demander « ces contraintes produisent-elles une architecture que nous voulons maintenir ? »
Choisir Git comme source de vérité n’est pas une règle universelle. Dans un autre système, un registre transactionnel pourrait légitimement porter l’état. Ici, la décision locale était de ne pas inventer une seconde réalité à synchroniser. Ce genre de choix doit être attaché au travail, pas seulement approuvé d’un « oui » au milieu du fil.
L’agent de code peut écrire beaucoup. Il ne doit pas être obligé d’être simultanément l’auteur, le témoin, le juge et l’archive de sa propre décision.
14. Tester, c’est aussi refuser une fausse facilité
Le TESTER de la scène d’ouverture ne devait pas simplement ajouter quelques assertions. Il devait déplacer des tests unitaires mêlés au code fonctionnel vers une structure externe, préparer des scénarios absents et préserver le comportement de la hot pipeline.
Le périmètre a été négocié. Après qu’un autre agent a pris en charge le runtime DCMTK statique sous Windows, le TESTER a limité son travail aux tests, à la configuration, à HTTP, à SQLite et aux intégrations correspondantes. Cette limitation était une propriété du travail en cours, pas un trait de personnalité du modèle.
Une décision de testabilité a aussi révélé la qualité de cette frontière. Il aurait été plus commode d’exposer une méthode Deserialize dans l’API de production pour simplifier certains tests. L’agent a refusé d’élargir ce contrat uniquement pour le confort de la suite et a choisi un chemin d’intégration réel.
Je ne transforme pas ce choix en maxime. Il existe des cas où une API testable est aussi une meilleure API. Il existe aussi des points d’injection légitimes, des ports, des doubles et des interfaces explicitement conçues pour isoler les dépendances. Ici, le compromis local était différent : l’ouverture proposée n’exprimait pas une capacité métier ; elle fuyait une commodité de test dans le produit.
Cette nuance est exactement ce qu’une responsabilité TESTER devrait porter. Son objectif n’est pas de « faire passer les tests ». Il doit chercher des preuves sur le comportement sans réécrire subrepticement le contrat pour faciliter leur production.
Le système doit alors conserver quatre choses : le contrat testé, les scénarios choisis, les limites de couverture et les résultats. Un nombre vert sans ces quatre repères est un signal agréable, pas une preuve complète.
La coordination avec le FIXER ajoutait une cinquième dimension : le moment. Les corrections fonctionnelles pouvaient avancer, mais les nouveaux scénarios devaient attendre la structure commune. Le test n’était plus seulement une activité ; il avait une dépendance explicite dans le workflow.
15. La review indépendante n’est pas un second bouton « vérifier »
Une revue indépendante apporte quelque chose seulement si elle peut désobéir au cadre mental de l’implémentation.
Si le reviewer reçoit uniquement le résumé enthousiaste de l’agent qui vient de coder, il hérite déjà de ses angles morts. S’il travaille dans le même contexte saturé de décisions intermédiaires, il peut confondre la familiarité avec la validité. S’il n’a ni spécification versionnée, ni diff stable, ni résultats des contrôles, son indépendance devient surtout de l’amnésie.
Le cas des worktrees illustre une revue utile : les checks étaient connus, le code existait, et la demande consistait précisément à vérifier ce qui restait. Les findings ont ensuite déclenché un choix d’architecture sur la source de vérité. La revue n’a pas annulé les tests ; elle a examiné un niveau de risque qu’ils ne capturaient pas.
Le cas de la seconde revue de spécification ajoute un autre axe. Un agent Codex chargé de la spec a demandé à une session Claude configurée avec un effort élevé de relire indépendamment un document. Encore une fois, ce n’est pas un comparatif de fournisseurs. Le bénéfice recherché venait du changement de responsabilité et de contexte : un autre exécutant, mandaté pour contester, sur un artefact durable.
Une bonne review d’agent devrait donc déclarer :
- l’objet exact examiné et sa version ;
- le mandat, par exemple correction, architecture, sécurité ou cohérence avec la spec ;
- les contrôles déjà passés et leurs limites ;
- les findings avec leur gravité et leur preuve ;
- les décisions humaines qui acceptent, rejettent ou reportent ces findings.
Sans cette dernière ligne, la revue produit une nouvelle collection d’opinions. Avec elle, le projet conserve non seulement ce qui a été trouvé, mais aussi ce qui a été décidé.
Séparer l’implémentation de la review n’est pas toujours nécessaire. Pour une petite modification réversible, relire le diff dans la même session peut suffire. L’indépendance mérite son coût quand l’intention de l’auteur risque de masquer le comportement réel, quand l’architecture change ou quand la preuve doit convaincre quelqu’un d’autre que son producteur.
Il faut aussi empêcher la review de devenir un concours de commentaires. Un modèle mandaté pour « trouver des problèmes » peut produire une liste impressionnante de possibilités théoriques. Sans sévérité, chemin de reproduction, référence au code et conséquence concrète, la quantité de findings mesure surtout l’obéissance au prompt.
Je préfère un résultat plus ingrat : zéro finding quand rien de matériel n’est démontré, quelques points classés quand la preuve existe, et des questions explicitement marquées comme telles lorsque le contexte manque. Une revue qui invente une certitude négative n’est pas plus rigoureuse qu’une implémentation qui invente une certitude positive.
Le traitement des findings fait partie du workflow. Un problème moyen peut être corrigé immédiatement, accepté avec justification ou transformé en travail ultérieur. Un point faible peut révéler une incohérence conceptuelle qui mérite plus d’attention qu’un bug local sévère mais évident. La gravité aide à prioriser ; elle ne remplace pas le jugement sur la trajectoire du système.
Enfin, l’indépendance ne doit pas interdire le dialogue. Le reviewer peut demander le contrat manquant, l’implémenteur peut corriger une lecture factuellement fausse, et l’humain peut arbitrer. Ce qui doit rester séparé, c’est la provenance des observations. Si le rapport final réécrit toutes les objections pour les faire ressembler à l’intention initiale, nous avons gagné une conversation polie et perdu la revue.
16. Spécialiser les modèles est une allocation, pas un classement
Les discussions sur les agents glissent vite vers le championnat des providers. Quel modèle code le mieux ? Lequel comprend vraiment l’architecture ? Lequel faut-il mettre partout avec l’effort maximal ? Ces questions promettent une réponse simple à un problème qui ne l’est pas.
Dans un système d’ingénierie, je préfère raisonner par allocation. Une responsabilité possède un intrant, un niveau de risque, des outils, une contrainte de temps et un type de preuve. À partir de là, je choisis un provider, un modèle et un effort, puis j’évalue le résultat sur un travail représentatif.
La spécification bénéficie parfois d’un contexte large et d’un raisonnement soutenu. Une modification mécanique peut privilégier vitesse et coût. Un TESTER a besoin des contrats, des scénarios et de l’environnement d’exécution ; lui donner tout l’historique produit peut surtout ajouter du bruit. Une review indépendante peut justifier un autre provider ou une session neuve, non parce que la marque garantit la contradiction, mais parce que l’on cherche à réduire le couplage au raisonnement initial. Une release exige moins de créativité et davantage de gates déterministes, d’idempotence et d’autorité explicite.
Les contrôles d’effort rendent cette allocation plus fine. La documentation Claude Code expose /effort pour les modèles compatibles, avec une disponibilité dépendante du modèle (commandes Claude Code). OpenAI expose également des familles et des réglages aux compromis différents (catalogue des modèles OpenAI). Les noms, les prix, les tailles de contexte et même les niveaux disponibles changent ; je n’ai pas besoin de les figer ici.
Ce que mon exemple xhigh établit est modeste : j’ai assigné un effort élevé à une seconde revue de spec reçue d’un agent connecté. Il n’établit ni supériorité universelle, ni gain mesuré, ni recette.
La bonne abstraction n’est pas « le meilleur modèle ». C’est une politique d’exécution vérifiable : pour ce type de travail, avec ce risque et ce budget, quel exécutant produit la preuve suffisante ?
17. Quand l’orchestration ment avec aplomb
Construire une couche au-dessus des chats ne suffit pas. Elle peut même rendre le système pire si elle transforme des inférences fragiles en statuts rassurants.
Je l’ai appris sur la détection de l’état des coding agents. L’interface affichait running alors que Claude Code attendait une permission. Après un fork de session, Codex restait bloqué en ATTENTION. Des tâches se terminaient sans notification ponctuelle fiable. Les statuts ne correspondaient pas à ce qui se passait réellement.
Le premier réflexe aurait pu être d’ajouter encore quelques heuristiques : reconnaître davantage de texte du terminal, combiner des timings, interpréter des motifs propres à chaque provider. Nous avons pris la direction inverse. Le problème a été requalifié comme un défaut de modélisation. J’ai demandé de refaire entièrement la spécification, puis de supprimer les tentatives d’intercepter des signaux internes non fiables. Nous avons conservé uniquement les états justifiables par des faits PTY ou UI observables.
Cette retraite était un progrès.
Un orchestrateur est tenté de tout nommer : thinking, waiting, needs attention, done. Mais si le provider ne fournit pas un événement stable pour ces états, le label n’est pas une connaissance. C’est une interprétation rendue officielle par une couleur.
L’erreur a un coût supérieur à un simple badge faux. Un workflow peut relancer un travail supposé bloqué, envoyer deux fois une demande dont l’issue est ambiguë, autoriser une étape suivante parce qu’un agent paraît terminé, ou cacher une demande de permission derrière un statut « en cours ». Plus l’automatisation fait confiance au statut, plus l’heuristique devient dangereuse.
L’orchestration digne de confiance doit savoir dire « inconnu ». Elle doit distinguer l’état du terminal, l’état de livraison d’un message, l’état d’une tâche et l’état métier d’une spécification. Elle doit aussi conserver l’événement qui justifie chaque transition.
Le nombre d’agents dans un diagramme ne prouve rien. La manière dont le système recule après avoir découvert une fausse certitude en dit beaucoup plus.
Cette règle impose une discipline peu spectaculaire. Un état affiché doit avoir une source nommable et une transition reproductible. running peut signifier que le processus PTY vit ; il ne doit pas être présenté comme la preuve que le modèle raisonne encore. stopped peut décrire le terminal ; il ne dit pas si la tâche métier est terminée. delivered peut qualifier un message ; il ne prouve pas que son contenu a été appliqué. Chaque mot reste dans le domaine où son observation est fiable.
Quand aucun signal ne permet de savoir, le workflow doit s’arrêter ou demander une vérification. C’est frustrant, surtout face à une interface qui pourrait afficher une jolie animation. Mais une inconnue explicite protège mieux le projet qu’une transition automatique fondée sur un prompt de terminal susceptible de changer avec la prochaine version du provider.
L’observabilité d’un système agentique commence donc par la modestie de son modèle. Collecter davantage de traces n’autorise pas à leur attribuer davantage de sens. Les événements, les logs et les captures aident à diagnostiquer ; les invariants doivent reposer sur les quelques faits dont le système contrôle réellement la production.
18. Livrer est une responsabilité différente
Une release n’est pas l’ultime message heureux d’une session de code. C’est un passage d’autorité.
Dans un de mes workflows, j’ai autorisé la génération des packages tout en interdisant la promotion du site avant des tests supplémentaires sous Windows et Linux. Le logiciel pouvait être emballé ; il n’était pas encore autorisé à devenir la version publique. Cette distinction est simple à écrire et facile à perdre si package generated se transforme implicitement en ready to ship.
Plus tard, un bug critique a été découvert pendant une autre tentative. J’ai demandé si nous pouvions encore arrêter. Le candidat a été abandonné avant la création de la release correspondante. Dans un épisode distinct, une mauvaise version stable a dû être retirée du canal. L’ordre était de procéder de manière réversible, en préservant autant que possible le tag, les artefacts et les preuves. La session a aussi rencontré une limitation de permission lors de la purge du cache.
Ces faits sont bornés : un candidat interrompu, un rollback réversible et une limitation opérationnelle. Ils ne prouvent pas que le processus garantit toutes les releases futures. Ils montrent pourquoi la livraison mérite ses propres objets.
Un dispositif de release sérieux sépare au moins :
- les artefacts candidats ;
- les contrôles par plateforme ;
- la décision de promotion ;
- l’identité de la version exposée par les canaux ;
- les preuves de santé ;
- la stratégie de pause ou de rollback ;
- les opérations incomplètes faute de permission.
L’ADR consacré à la distribution desktop formalise précisément des gates natives, une préversion avant promotion manuelle, le comportement de mise à jour et de redémarrage, ainsi que les métadonnées de pause et de retour arrière. Le point essentiel reste humain : je peux déléguer la préparation, les contrôles et même l’exécution déterministe d’une procédure. Je ne délègue pas silencieusement l’autorité de promouvoir ou de retirer une version.
L’agent doit pouvoir faire le travail de release. Le système doit empêcher qu’il confonde capacité d’action et permission d’agir.
19. La facture arrive après le prototype
Un autre dépôt fournit un contraste utile, à condition de rester très précis sur ce qu’il prouve.
Au 5 mars 2026, le prototype Asaph comptait 50 fichiers TypeScript ou TSX suivis. Aucun fichier de test ou de spec n’était suivi. Dans les routes API échantillonnées pour bands et volunteers, les handlers importaient Prisma directement, lisaient request.json() sans frontière de validation, utilisaient des formes de requête inline et appelaient l’ORM dans les routes.
Ces éléments décrivent une forme de code. Ils ne prouvent ni que l’application était défectueuse, ni pourquoi elle avait cette forme, ni que des agents avaient écrit chaque ligne.
La suite de l’historique est néanmoins concrète. Le 6 mars, une migration de Prisma vers Mikro-ORM et une nouvelle organisation orientée domaine ont produit 9 175 insertions et 2 401 suppressions. Le 10 mars, des tests d’intégration étendus et un refactoring des services ont ajouté 4 388 lignes et en ont supprimé 70. Le 15 mars, des contrôleurs applicatifs, un DTO commun, des adaptateurs plus fins et davantage de tests ont entraîné 3 139 insertions et 1 236 suppressions. Le 17 mars, les méthodes de service ont adopté des paramètres objets et la gestion des erreurs API a encore évolué.
Les volumes de diff ne mesurent pas la qualité. Ils ne permettent pas non plus d’attribuer causalement les changements à l’absence initiale de tests. Ils montrent une chose plus modeste : une forme de prototype très directe a été suivie, en quelques jours, par de grandes révisions structurelles et de test.
Voilà la facture d’itération que l’abondance de code peut masquer. Un prototype arrive vite, donne l’impression que le problème est presque résolu, puis les frontières, les contrats et les preuves réclament leur dû. Cette facture peut être parfaitement acceptable. Parfois, apprendre par le code est la stratégie rationnelle. Le danger consiste à présenter la vitesse de la première passe comme la vitesse du système livré.
Je ne veux pas interdire le prototype rapide. Je veux rendre explicite son statut : exploration, hypothèses ouvertes, dette connue, critères pour durcir l’architecture. Tant que ces éléments n’existent que dans la tête — ou dans le chat — le prochain agent reçoit du code sans savoir quelles parties étaient délibérément provisoires.
20. L’autorité reste après la délégation
Le meilleur contre-argument à toute cette thèse reste pratique. Une session moderne sait déjà lire les fichiers, appeler les outils, compacter son contexte, lancer des sous-agents, changer de modèle et poursuivre un travail pendant longtemps. Pour un ingénieur seul ou une tâche cohérente, ajouter une couche d’orchestration peut créer davantage d’état, de latence et de pannes qu’elle n’en supprime.
Je suis d’accord.
Restez dans une conversation quand le travail conserve une responsabilité claire, que le risque est local et que la validation tient dans le même contexte. Utilisez un grand contexte lorsque l’inspection transversale est réellement nécessaire. Ne créez pas un agent par rôle pour satisfaire un organigramme imaginaire. Et si l’orchestrateur ne sait pas distinguer un fait observable d’une inférence, il mérite moins de confiance que le terminal qu’il prétend simplifier.
La séparation devient utile quand une décision doit survivre à un changement de contexte ; quand deux travaux peuvent se chevaucher ; quand une preuve doit être produite indépendamment ; quand l’exécutant change ; quand une soumission ambiguë ne peut pas être répétée ; ou quand la release exige une autorité explicite.
Ces déclencheurs peuvent être testés sans construire une plateforme entière. Pour chaque travail, je peux poser quelques questions concrètes. Si cette session disparaît maintenant, qu’est-ce qui manque au prochain exécutant ? Deux personnes ou agents peuvent-ils modifier le même invariant ? Le résultat sera-t-il accepté sur la parole de celui qui l’a produit ? Une opération externe peut-elle avoir réussi sans accusé de réception ? La prochaine étape a-t-elle un effet public ou difficilement réversible ?
Une réponse affirmative indique le type d’artefact nécessaire. Une décision fragile appelle une spec ou un ADR. Un chevauchement appelle un propriétaire et un handoff. Une preuve contestable appelle un reviewer indépendant et un objet stable à examiner. Une soumission ambiguë appelle une identité d’opération et une résolution manuelle avant toute relance. Une promotion appelle une gate, un décideur et un chemin de rollback.
La matrice n’impose pas un agent distinct pour chaque ligne :
| Responsabilité | Intrant durable | Preuve attendue | Autorité humaine |
|---|---|---|---|
| Spécification | Besoin, contraintes, décisions ouvertes | Critères, contradictions, gates | Choisir le périmètre et les compromis |
| Implémentation | Spec et état du dépôt | Diff, build, types, lint | Valider la direction architecturale |
| Tests | Contrat et scénarios de régression | Résultats et limites de couverture | Accepter le compromis de testabilité |
| Review | Diff stable, spec et contrôles | Findings corroborés | Accepter, rejeter ou reporter |
| Release | Candidat, gates et plan de rollback | Contrôles de plateforme et reçus | Promouvoir, retenir ou retirer |
Une même session peut remplir plusieurs lignes quand l’indépendance n’apporte rien. Le découpage sert le risque ; il ne sert pas la décoration du canvas.
Dans ces cas, le système peut rester simple. Une spécification versionnée. Un propriétaire. Un handoff avec un état. Un diff stable. Des résultats de tests attachés au bon commit. Une review dont les findings et les décisions sont conservés. Une gate de release qui ne confond pas package et promotion. Pas besoin de baptiser chaque flèche avec un terme grec.
Cet article ne fournit aucune preuve permettant de prédire ce qu’une future IA fera de ces responsabilités. Les cas documentés ici montrent seulement qu’une capacité accrue peut en déplacer l’exécution ; dans ces cas, les décisions sur le produit, la preuve jugée suffisante, le risque accepté et la responsabilité de la release doivent encore être explicites.
Je veux des agents capables de spécifier, coder, tester, relire et livrer. Je veux surtout que chacun de ces actes laisse un objet vérifiable, qu’un autre exécutant puisse reprendre sans dépendre d’un souvenir synthétique. L’humain peut alors déléguer beaucoup sans feindre que l’autorité s’est évaporée avec le prompt.
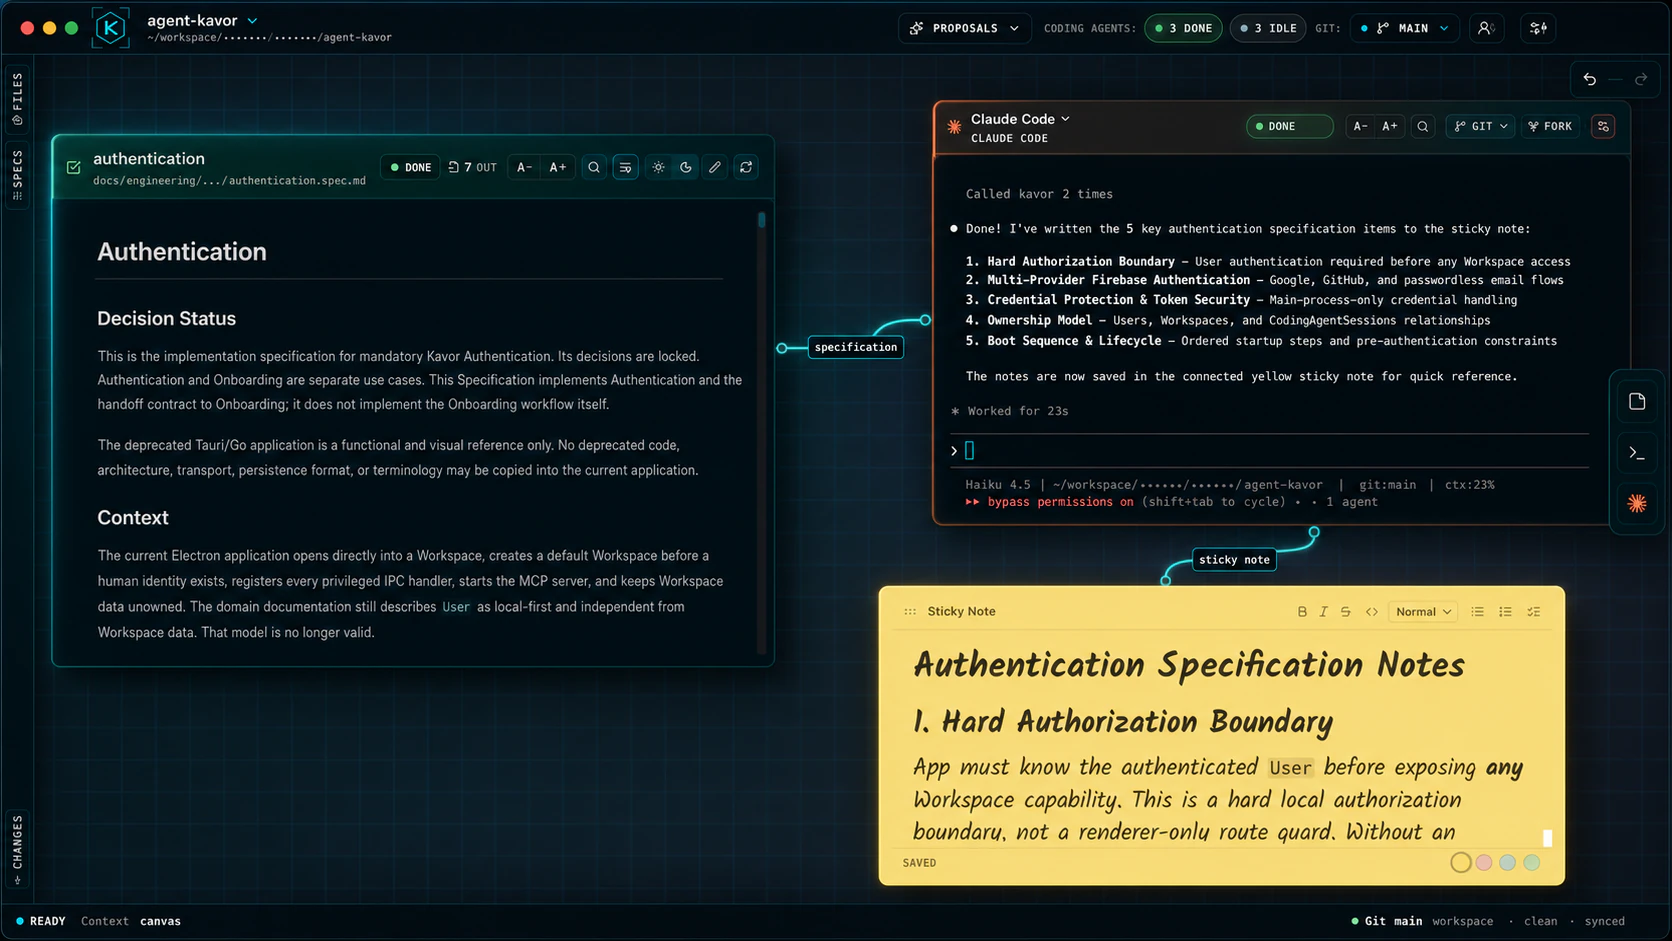
C’est la couche d’ingénierie que j’essaie de construire avec Agent Kavor.
Qu’est-ce que cet article a suscité ?
Choisissez plusieurs options et annulez-les à tout moment.
Commentaires
Chargement des commentaires…